
Wyszukiwarka oparta wyłącznie na słowach może nie połączyć pytania „jak odzyskać bazę?” z dokumentem zatytułowanym „przywracanie PostgreSQL z kopii”. Embeddings pomagają porównywać treści według wyuczonej reprezentacji, więc identyczne słownictwo przestaje być jedynym warunkiem dopasowania. Nie oznacza to jednak, że podobny wynik jest prawdziwy albo właściwy dla każdego użytkownika.
W tym artykule zobaczysz, czym jest wektor tekstu, jak porównuje się dwa wektory i gdzie ta metoda pasuje do aplikacji AI. Przejdziemy również przez prosty rachunek w Pythonie oraz przykład pobrania embeddingów z lokalnego API, bez udawania, że demonstracyjne liczby są wynikiem benchmarku modelu.
Czym są embeddings
Embedding to liczbowa reprezentacja danych wyznaczona przez model. Dla tekstu wynikiem jest wektor, czyli uporządkowana lista liczb. Model został nauczony reprezentować określone zależności tak, aby porównanie wektorów było przydatne w zadaniach takich jak wyszukiwanie lub grupowanie.
Nie odczytuje się go zwykle jak tabeli z podpisanymi kolumnami „Docker”, „backup” i „pilne”. Pojedyncza współrzędna nie musi mieć prostego znaczenia dla człowieka. Użyteczna informacja wynika z całej reprezentacji oraz sposobu jej porównania.
Embedding nie jest streszczeniem w języku naturalnym ani szyfrowaniem tekstu. Nie zastępuje dokumentu źródłowego, którego potrzebujesz do wyświetlenia wyniku i sprawdzenia odpowiedzi. Nie należy również zakładać, że wektor pozbawia dane wrażliwości. To nadal reprezentacja utworzona z określonego materiału i powinna podlegać odpowiednim zasadom dostępu.
Modele embeddingowe różnią się przeznaczeniem. Jedne sprawdzają się przy krótkich podobnych zdaniach, inne przy wyszukiwaniu odpowiedzi na pytanie w długim fragmencie. Znaczenie ma język, dziedzina i sposób przygotowania wejścia. Polski poradnik administracyjny nie musi zachowywać się tak jak angielski zbiór ogólnych zdań.
Co dzieje się podczas wyszukiwania
Najpierw przygotowujesz dokumenty lub ich fragmenty i wyznaczasz dla nich wektory. Zapisujesz je wraz z identyfikatorem źródła oraz metadanymi. Gdy użytkownik wpisuje pytanie, tworzysz reprezentację zapytania i wyszukujesz podobne wektory w dozwolonym zbiorze.
Wynik tej operacji to lista kandydatów, nie gotowa odpowiedź językowa. Aplikacja może pokazać ich tytuły i fragmenty bez uruchamiania modelu generującego tekst. Dopiero jeśli chce zbudować odpowiedź na ich podstawie, dołącza znalezione materiały do osobnego wywołania.
Właśnie w tym miejscu embeddings często łączą się z RAG. Są jedną z metod wyszukiwania kontekstu, a nie całym systemem RAG. Potrzebne pozostają aktualne dokumenty, poprawne uprawnienia, selekcja wyników oraz kontrola odpowiedzi.
Wyobraź sobie bazę poradników o serwerach. Pytanie o odzyskanie danych może prowadzić do konfiguracji kopii PostgreSQL. Pytanie o kontener, który nie łączy się z bazą, powinno raczej wskazać procedurę diagnostyczną. Oba teksty dotyczą bazy danych, ale odpowiadają na inną potrzebę. To dobry przypadek do testowania trafności wyszukiwania.
Podobieństwo kosinusowe bez trudnej matematyki
Jednym ze sposobów porównania jest podobieństwo kosinusowe. Sprawdza kierunek wektorów: dzieli ich iloczyn skalarny przez iloczyn długości. Dla niezerowych wektorów otrzymujemy liczbę z przedziału od -1 do 1. Większa wartość oznacza bardziej zbliżony kierunek w tej metryce.
Nie jest to procent prawdopodobieństwa poprawnej odpowiedzi. Wynik 0,8 nie oznacza „80% pewności”, a próg dobry dla jednego modelu nie musi działać dla innego. Rozkład wyników zależy także od dokumentów i pytań.
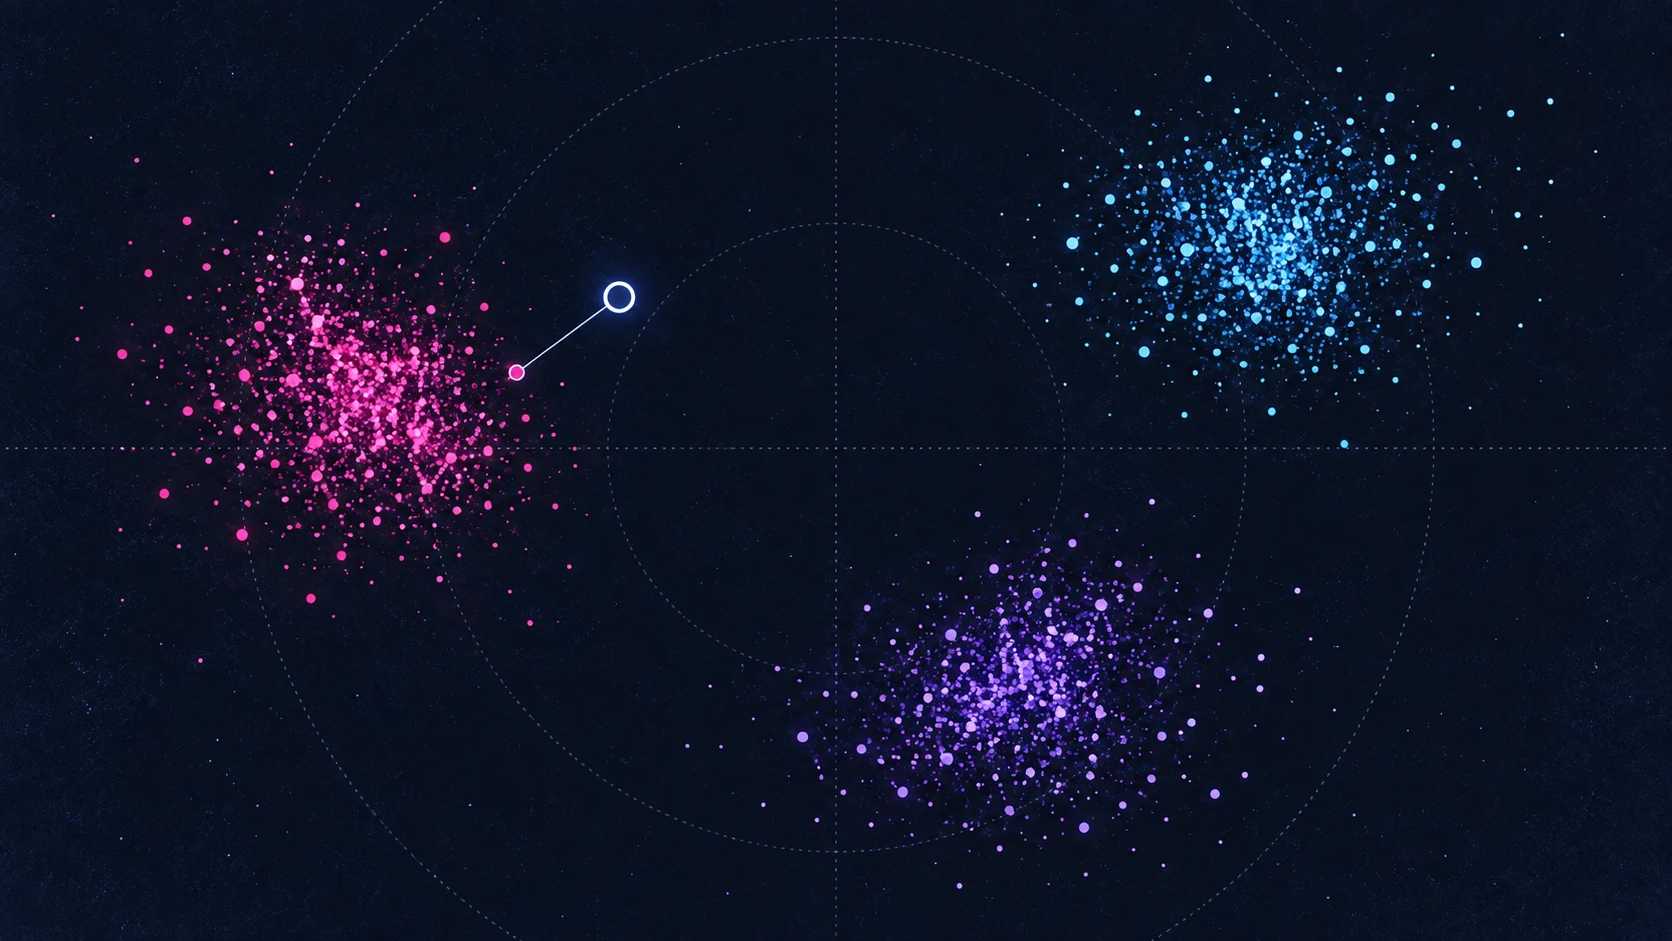
Poniższy kod używa ręcznie dobranych wektorów dwuwymiarowych. Pokazuje wyłącznie obliczenie oraz ranking, nie jakość żadnego modelu embeddingowego:
from math import sqrt

def cosine(a, b):
    if len(a) != len(b):
        raise ValueError("Rozne wymiary")
    norm_a = sqrt(sum(x * x for x in a))
    norm_b = sqrt(sum(x * x for x in b))
    if norm_a == 0 or norm_b == 0:
        raise ValueError("Wektor zerowy")
    return sum(x * y for x, y in zip(a, b)) / (norm_a * norm_b)

query = [1.0, 0.0]
documents = {
    "A": [0.9, 0.1],
    "B": [0.2, 0.8],
    "C": [-1.0, 0.0],
}

ranking = sorted(
    ((name, cosine(query, vector)) for name, vector in documents.items()),
    key=lambda item: item[1],
    reverse=True,
)
for name, score in ranking:
    print(name, f"{score:.4f}")
Wynik:
A 0.9939
B 0.2425
C -1.0000
A wskazuje prawie w tym samym kierunku co zapytanie. C wskazuje w przeciwnym. Nazwy nie opisują rzeczywistych dokumentów i nie przypisujemy im znaczenia semantycznego. W prawdziwej wyszukiwarce wektory wyznacza model, a ocenę trafności przeprowadzasz na parach pytanie-dokument.
Rysunki z punktami są uproszczeniem. Wiele reprezentacji ma setki lub więcej wymiarów, więc płaska mapa służy do wyjaśnienia idei. Nie jest wiernym obrazem całej przestrzeni ani dowodem, że każdy temat tworzy idealnie oddzieloną grupę.
Jeden model i spójne przygotowanie danych
Do indeksowania dokumentów i obsługi zapytań używaj zgodnego modelu oraz ustawień. Dwa wektory o tej samej długości nie muszą należeć do porównywalnej przestrzeni. Zamiana modelu bez ponownego przeliczenia zbioru może dawać liczbowo poprawne, lecz bezwartościowe wyniki.
Niektóre modele lub biblioteki rozróżniają kodowanie zapytania i dokumentu. Mogą wymagać odpowiedniego prefiksu lub metody. Wyszukiwanie krótkiego pytania w długich tekstach jest innym zadaniem niż szukanie parafraz krótkiego zdania. Stosuj zalecenia wybranego modelu, zamiast zakładać identyczne wejście dla wszystkich zastosowań.
Zapisuj nazwę, wersję lub identyfikator modelu, liczbę wymiarów, reguły dzielenia tekstu i datę aktualizacji indeksu. Jeżeli zmieniasz te parametry, zbuduj nowy indeks obok starego, porównaj wyniki i dopiero wtedy przełącz aplikację. Mieszanie reprezentacji w jednej kolekcji utrudnia zarówno testy, jak i późniejsze wycofanie zmiany.
Pobranie prawdziwych embeddingów lokalnie
Jeśli masz już działającą Ollamę, możesz użyć osobnego modelu embeddingowego. W przykładzie wybieramy embeddinggemma, wskazany w dokumentacji Ollamy. To nie jest ten sam model rozmowy co Qwen z poprzedniego poradnika.
Najpierw pobierz model:
ollama pull embeddinggemma
Następnie w Pythonie 3 wyślij dwa demonstracyjne teksty do /api/embed:
import json
import urllib.request

payload = {
    "model": "embeddinggemma",
    "input": [
        "Przywracanie bazy PostgreSQL z kopii zapasowej.",
        "Jak odzyskac baze po awarii?"
    ],
    "truncate": False
}
request = urllib.request.Request(
    "http://127.0.0.1:11434/api/embed",
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"},
    method="POST"
)
with urllib.request.urlopen(request, timeout=180) as response:
    result = json.load(response)

vectors = result["embeddings"]
print("Liczba wektorow:", len(vectors))
print("Wymiar:", len(vectors[0]))
Przykład wymaga pobranego modelu i dostępnego lokalnego serwera. Nie podaję zmyślonego wyniku podobieństwa: uruchomienie na Twojej wersji ma dostarczyć rzeczywiste wektory. Możesz potem przekazać obie listy do funkcji cosine z wcześniejszej sekcji.
truncate: false powoduje zgłoszenie błędu zamiast cichego skracania zbyt długiego wejścia. To przydatne podczas budowania indeksu, ponieważ ucięcie dokumentu mogłoby pozostać niezauważone. W produkcji obsłuż taki błąd przez poprawny podział treści, a nie automatyczne pominięcie problematycznego rekordu.
Do kontroli struktury neutralnego żądania przyda się formatter JSON. Nie musisz wypisywać całych wektorów do logów. Do diagnostyki zwykle wystarczą liczba wyników, wymiar, identyfikator modelu i informacja, który dokument przetworzono.
Jak dzielić dokumenty na fragmenty
Zbyt duży fragment może łączyć kilka tematów i utrudniać znalezienie konkretnej odpowiedzi. Zbyt mały może stracić warunek, nagłówek albo informację, czego dotyczy polecenie. Nie ma jednej długości właściwej dla instrukcji, umowy i kodu źródłowego.
Zacznij od struktury dokumentu: sekcji, akapitów i bloków kodu. Zachowaj tytuł oraz identyfikator źródła. Nie oddzielaj ostrzeżenia od polecenia, które ono ogranicza. Przy tabeli upewnij się, że fragment zawiera nagłówki, bez których liczby byłyby nieczytelne.
Częściowe nakładanie fragmentów może pomóc zachować ciągłość, ale zwiększa liczbę rekordów i powtarzalność wyników. Jeśli trzy pierwsze trafienia są prawie identyczne, aplikacja marnuje miejsce w kontekście. Warto usuwać duplikaty i grupować trafienia według dokumentu przed przekazaniem ich dalej.
Pamiętaj, że model generujący odpowiedź ma własne okno kontekstowe. Wyszukanie dwudziestu fragmentów nie oznacza, że wszystkie warto wysłać. Dobór kontekstu jest następnym etapem, a nie automatycznym skutkiem rankingu.
Czy potrzebna jest osobna baza wektorowa
Do małego eksperymentu wystarczy lista wektorów i dokładne porównanie z każdym elementem. Pozwala to zrozumieć mechanizm bez uruchamiania kolejnej usługi. Wraz ze wzrostem zbioru pojawiają się wymagania dotyczące czasu wyszukiwania, aktualizacji i filtrowania.
Możesz wykorzystać rozwiązanie wyspecjalizowane albo rozszerzenie istniejącej bazy, na przykład pgvector w PostgreSQL. Wybór zależy od projektu, nie od samego słowa „AI”. Jeżeli dane i uprawnienia już mieszkają w Postgresie, integracja z nim może uprościć utrzymanie. Osobny silnik oznacza dodatkowe kopie, monitoring i procedury odtwarzania.
Indeksy przybliżone mogą przyspieszać wyszukiwanie kosztem możliwości pominięcia części najbliższych wyników. Przed ich oceną porównaj rezultat z dokładnym wyszukiwaniem na próbce. Inaczej trudno rozdzielić błąd modelu embeddingowego od kompromisu zastosowanego indeksu.
Przy pracy z SQL pomocna jest ściąga zapytań SQL, ale operator podobieństwa i indeks wektorowy wymagają dokumentacji konkretnego rozszerzenia. Nie zakładaj, że rosnący zbiór przyspieszy tylko dlatego, że dodano dowolny indeks.
Uprawnienia przed przekazaniem wyników do modelu
Wyszukiwarka musi ograniczyć wyniki do danych, które użytkownik może odczytać. Tożsamość i zakres dostępu powinny pochodzić z zaufanej warstwy aplikacji. Nie pozwalaj, aby model sam wybrał identyfikator klienta, działu lub organizacji i na tej podstawie uzyskał szerszy dostęp.
Filtry metadanych pomagają ograniczać zbiór, lecz trzeba sprawdzić sposób ich stosowania przez silnik. Pobranie kilku wyników z całej bazy i usunięcie niedozwolonych dopiero na końcu może dać słabą kompletność. Przekazanie niedozwolonych fragmentów do modelu, a następnie polecenie „nie ujawniaj ich”, jest już spóźnioną kontrolą.
Aktualizacja uprawnień powinna dotyczyć również indeksu. Usunięcie pliku źródłowego nie zawsze usuwa jego fragmenty z kolekcji. Zapisuj relację między dokumentem, wersją i wektorami, aby móc wycofać wszystkie kopie. To zadanie utrzymaniowe, które łatwo pominąć w atrakcyjnej demonstracji wyszukiwania.
Kiedy zwykłe wyszukiwanie jest lepsze
Dokładny numer zamówienia, nazwa parametru i kod błędu często wymagają dopasowania literalnego. Wektor może dobrze wskazać temat, ale pomylić bardzo podobne identyfikatory. Nie warto rezygnować z wyszukiwania tekstowego tam, gdzie użytkownik zna precyzyjny ciąg znaków.
Praktyczne rozwiązanie może łączyć wyniki tekstowe i semantyczne, a następnie oceniać kandydatów dodatkowym etapem rankingu. Taki układ wymaga testów: nie wystarczy połączyć dwóch list i uznać, że jakość wzrosła. Zapisz zestaw pytań z oczekiwanymi dokumentami oraz przypadki, w których poprawnym wynikiem jest brak dopasowania.
Mierz, czy potrzebny dokument pojawia się w pierwszych kilku wynikach, i czy aplikacja nie zwraca nieuprawnionych treści. Dodaj pytania z literówkami, po polsku, z dokładną nazwą komendy i z mylącym podobieństwem tematycznym. To bardziej użyteczne niż obserwowanie jednej efektownej odpowiedzi.
FAQ
Czy embedding potrafi napisać odpowiedź?
Sam wektor nie jest odpowiedzią językową. Służy do porównywania lub dalszego przetwarzania danych. Generowanie tekstu to osobny etap.
Czy można mieszać wektory z różnych modeli?
Nie należy zakładać ich zgodności. Ta sama liczba wymiarów nie wystarcza. Zmiana modelu zwykle wymaga ponownego wyznaczenia reprezentacji zbioru.
Czy wynik 0,9 oznacza 90% pewności?
Nie. To wartość konkretnej miary podobieństwa. Próg akceptacji należy dobrać na ocenionych przykładach z własnej aplikacji.
Czy embeddings zastępują bazę danych?
Nie. Nadal potrzebujesz źródeł, metadanych, aktualizacji i uprawnień. Wektory są dodatkową reprezentacją ułatwiającą wybrane operacje.
Czy embeddings nadają się do polskich tekstów?
Tak, jeśli wybrany model dobrze obsługuje taki materiał. Sprawdź to na polskich pytaniach i dokumentach z własnej dziedziny, zamiast polegać wyłącznie na ogólnym benchmarku.
Źródła
- Sentence Transformers: wyszukiwanie semantyczne.
- Sentence Transformers: miary podobieństwa.
- Ollama: modele embeddingowe.
- Ollama API: generowanie wektorów i limit wejścia.
- pgvector: dokładne i przybliżone wyszukiwanie w PostgreSQL.
- Qdrant: filtrowanie wyników według metadanych.
Data publikacji: 17.10.2026.
Dyskusja