
Odpowiedź „gotowe” w oknie czatu nie jest dowodem, że wpis został zapisany, plik zmieniony albo problem na serwerze rozwiązany. Różnica między prostym chatbotem a agentem AI ujawnia się właśnie tutaj: czy system tylko opisuje czynność, czy potrafi wybrać narzędzie, wykonać działanie i sprawdzić jego rezultat.
Żeby dobrze ocenić takie narzędzie, warto rozdzielić interfejs rozmowy, model językowy i aplikację, która wykonuje operacje. Poniżej porównuję trzy sposoby pracy oraz pokazuję hipotetyczny proces przygotowania wpisu na blog. To przykład architektury, a nie relacja z testu konkretnego produktu.
Agent AI a chatbot: najważniejsza różnica
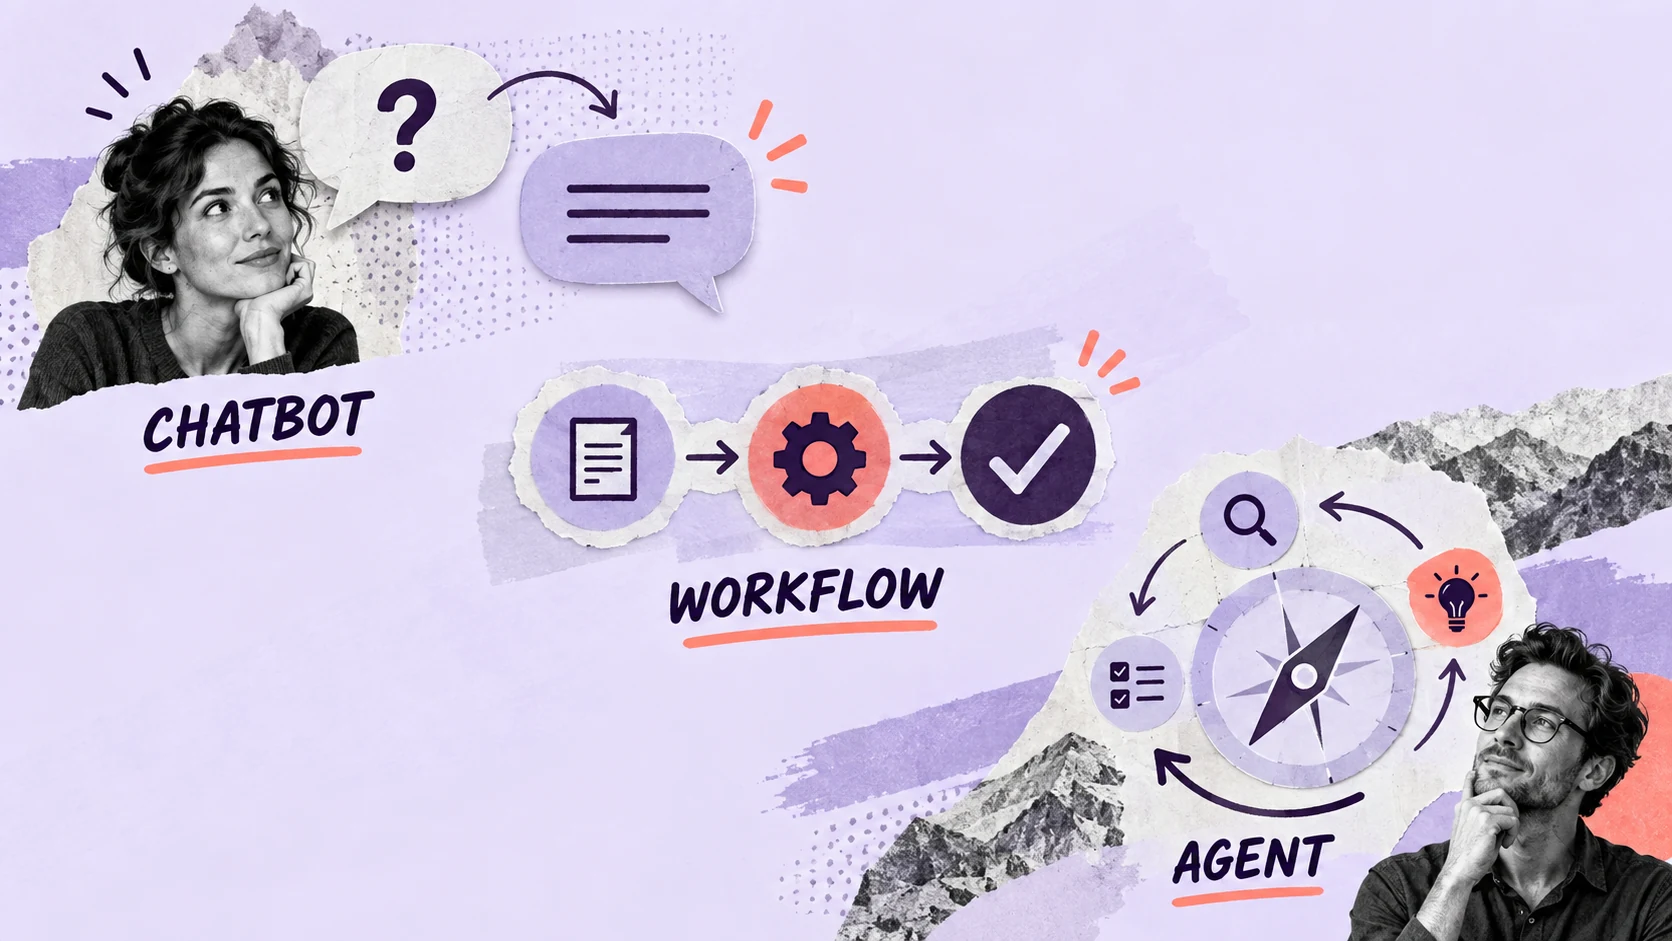
Prosty chatbot przyjmuje wiadomość i zwraca odpowiedź. Może wyjaśnić błąd, przygotować fragment kodu albo zaproponować treść e-maila. W takim wariancie dalsze działania wykonujesz sam: kopiujesz kod, uruchamiasz polecenie, wysyłasz wiadomość.
Agent AI otrzymuje cel i w określonych granicach dobiera kolejne działania. W systemach opartych na dużym modelu językowym, czyli LLM, model może wskazać potrzebne narzędzie i jego parametry. Aplikacja obsługuje wywołanie, przekazuje wynik z powrotem, a system ustala następny krok. Ogólną charakterystykę takich systemów opisuje Google Cloud.
Chat jest interfejsem, a agent opisuje sposób organizacji pracy. Możesz rozmawiać z agentem przez zwykłe okno czatu. Możesz też uruchomić go zdarzeniem z harmonogramu bez żadnej rozmowy. Sam wygląd aplikacji nie pozwala więc rozstrzygnąć, co dzieje się pod spodem.
Także przycisk wyszukiwania lub pojedyncze wywołanie funkcji nie dowodzą jeszcze, że masz do czynienia z agentem. Liczy się to, kto ustala przebieg zadania i czy kolejne kroki zależą od uzyskanych wyników.
Chatbot, workflow i agent to trzy różne sposoby pracy
Pomiędzy generowaniem odpowiedzi a agentem znajduje się zwykła automatyzacja, często nazywana workflow. Jej przebieg określa programista. Może zawierać warunki, rozgałęzienia oraz wywołania modelu AI, ale nadal porusza się po przygotowanych ścieżkach.
W opisie architektur Anthropic istotna granica przebiega między takim ustalonym przepływem a systemem, w którym model dynamicznie kieruje procesem i użyciem narzędzi. W praktyce oba podejścia można łączyć.
| Sposób pracy | Kto ustala kolejne kroki | Przykład przy blogu |
|---|---|---|
| Prosty chatbot | Użytkownik prowadzący rozmowę | Generuje propozycję wstępu |
| Workflow z AI | Kod oraz zapisane reguły | Pobiera formularz, tworzy szkic i wysyła powiadomienie |
| Agent AI | Model w granicach ustalonych przez aplikację | Analizuje braki w materiale, dobiera źródła i poprawia szkic po kontroli |
Przykładowo: formularz zawsze trafia do tego samego szablonu, potem do korekty i do folderu szkiców. To dobry kandydat na workflow. Agent staje się przydatny, gdy dopiero w trakcie pracy trzeba ustalić, czego brakuje, gdzie szukać informacji i jak zareagować na nietypowy wynik.
Nie warto dodawać swobody wyboru tam, gdzie znana sekwencja kroków wystarcza. Im więcej decyzji pozostawiasz modelowi, tym więcej zachowań trzeba sprawdzić i obserwować podczas działania.
Przepływ o ustalonej kolejności kroków łatwiej zrozumieć na przykładzie automatyzacji w n8n. Dopiero na tym tle widać, kiedy wybór kolejnego działania przez model wnosi dodatkową wartość.
Jak działa agent AI krok po kroku
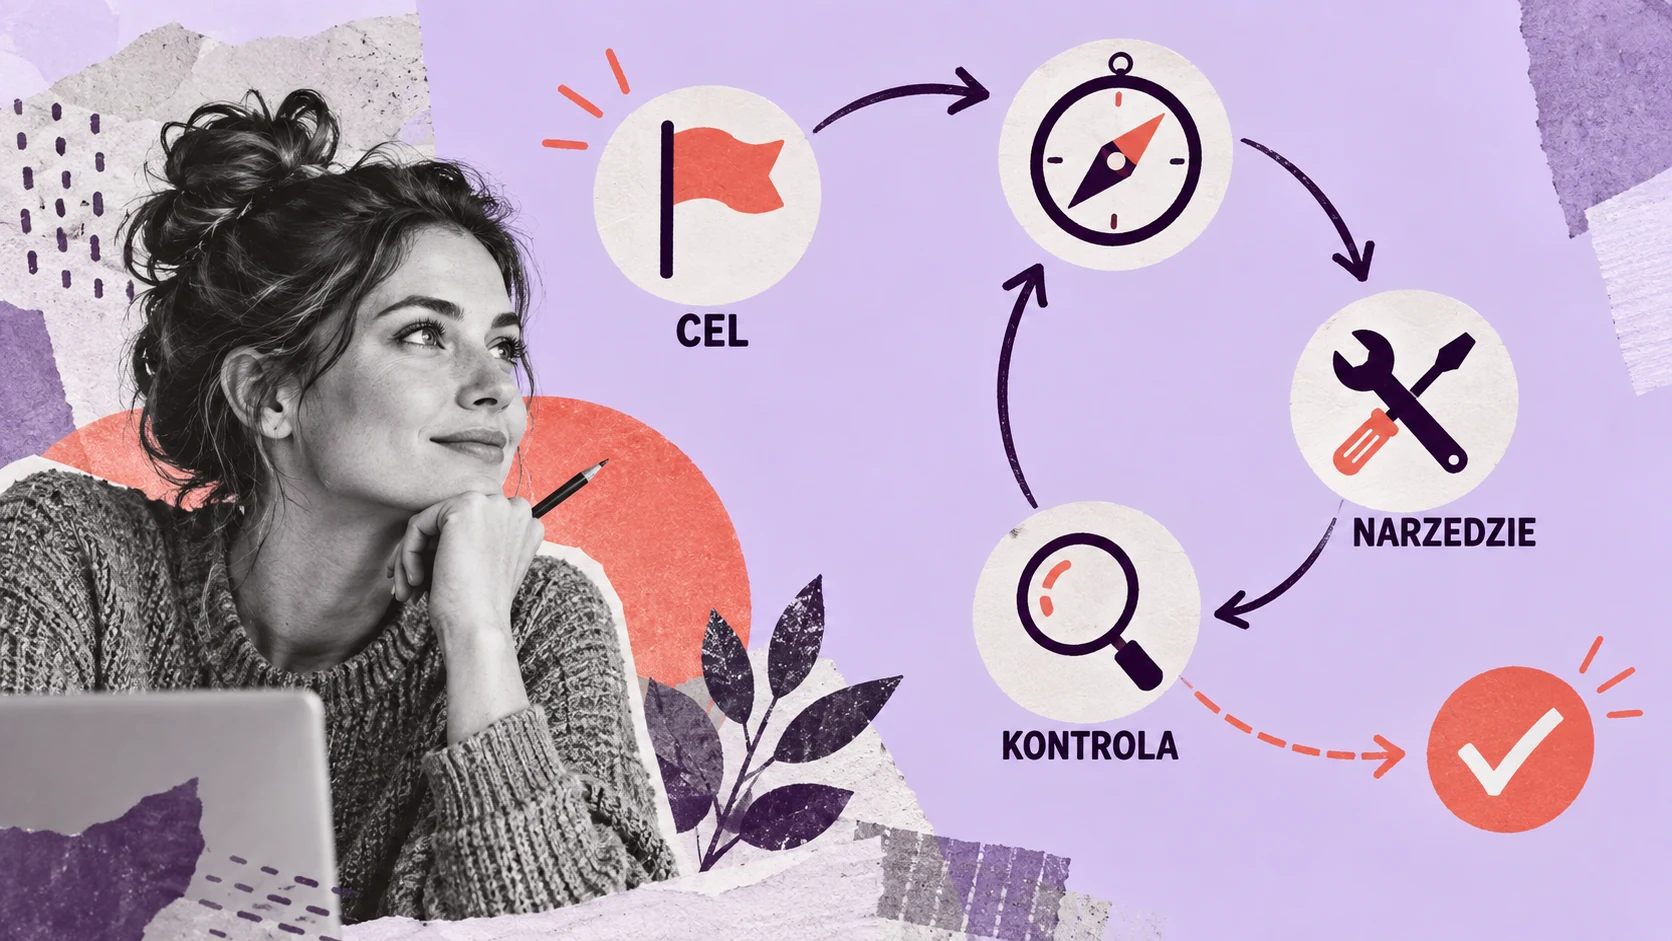
Typowy agent korzystający z narzędzi pracuje w pętli. Otrzymuje zadanie, wybiera działanie, dostaje wynik i decyduje, czy może zakończyć pracę. Nie musi wcześniej znać kompletnej listy kroków.
Wyobraź sobie polecenie: „Sprawdź szkic artykułu, uzupełnij brakujące źródła i zapisz poprawioną wersję”. Przebieg może wyglądać tak:
- Aplikacja przekazuje modelowi cel, treść szkicu i opis dostępnych narzędzi.
- Model wskazuje fragment wymagający sprawdzenia i proponuje wyszukanie dokumentacji.
- Narzędzie pobiera odpowiednią stronę, a aplikacja udostępnia jej treść modelowi.
- System porównuje źródło ze szkicem i przygotowuje korektę.
- Narzędzie zapisuje nową wersję, zwracając identyfikator dokumentu.
- Kolejny odczyt potwierdza zapis albo ujawnia problem, który wymaga poprawy.
Są tu dwa różne rodzaje kontroli. Model może oceniać sens tekstu, natomiast aplikacja powinna sprawdzać warunki techniczne: czy zapis się udał, czy dokument istnieje, czy identyfikator zgadza się z celem zadania. Sam komunikat modelu nie zastępuje tych sprawdzeń.
Pętla potrzebuje także warunku zakończenia. Może nim być uzyskanie poprawnego wyniku, brak wymaganych danych, konieczność decyzji człowieka albo przekroczenie limitu. Dobrze zaprojektowany system potrafi powiedzieć „nie udało się potwierdzić zapisu” zamiast bez końca powtarzać to samo wywołanie.
Model proponuje operację, narzędzie ją wykonuje
Model językowy sam w sobie nie zapisuje rekordu w WordPressie i nie uruchamia procesu na serwerze. Potrzebuje aplikacji udostępniającej odpowiednie funkcje. Wywołanie narzędzia może zawierać nazwę operacji i argumenty, na przykład identyfikator wpisu oraz nową treść.
To kod obsługujący integrację powinien sprawdzić argumenty, uprawnienia i wynik operacji. Klucz API lub konto usługi określa rzeczywisty zakres dostępu. Zdanie w promptcie nie zmieni uprawnień konta administratora na konto mające dostęp tylko do odczytu.
Warto udostępniać narzędzia o konkretnym przeznaczeniu. Funkcja „zapisz szkic wpisu” pozwala łatwiej ograniczyć zakres działania niż ogólne „wykonaj dowolne polecenie”. Dokumentacja parametrów oraz czytelne odpowiedzi narzędzi wpływają na to, czy model potrafi poprawnie ich użyć. Ten problem szerzej omawia materiał Anthropic o projektowaniu narzędzi.
Możesz też spotkać skrót MCP, czyli Model Context Protocol. Jest to sposób łączenia aplikacji AI z udostępnianymi narzędziami i zasobami. Architektura MCP opisuje rolę hosta, klienta i serwera. Samo podłączenie serwera MCP nie określa jeszcze autonomii agenta ani zasad zatwierdzania jego działań. To osobne decyzje projektowe.
Jednym ze sposobów przekazania zadania do aplikacji jest webhook. Gdy narzędzie otrzymuje dane JSON, do sprawdzenia ich składni przydaje się formatter i walidator JSON; poprawna składnia nadal nie potwierdza poprawności samej operacji.
Przykład: agent przygotowujący wpis na blog
Załóżmy, że chcesz uzyskać szkic poradnika na podstawie dokumentacji. Na początek definiujesz rezultat: wpis zapisany jako szkic, z poprawnymi linkami, metadanymi i listą kwestii wymagających decyzji autora.
Agent może najpierw przeczytać istniejące materiały. Jeżeli brakuje informacji o jednej funkcji, wyszukuje właściwą stronę dokumentacji. Gdy źródła są sprzeczne, powinien wskazać rozbieżność lub poprosić o rozstrzygnięcie. Następnie przygotowuje treść, zapisuje ją w systemie i sprawdza zapisany dokument.
Taki proces daje kilka konkretnych punktów kontroli. Najpierw porównaj twierdzenia artykułu ze źródłami i sprawdź cele odnośników. Następnie potwierdź status szkicu oraz liczbę utworzonych dokumentów. Ponowienie żądania nie powinno tworzyć kolejnych kopii.
Zapis szkicu i publikacja to oddzielne operacje
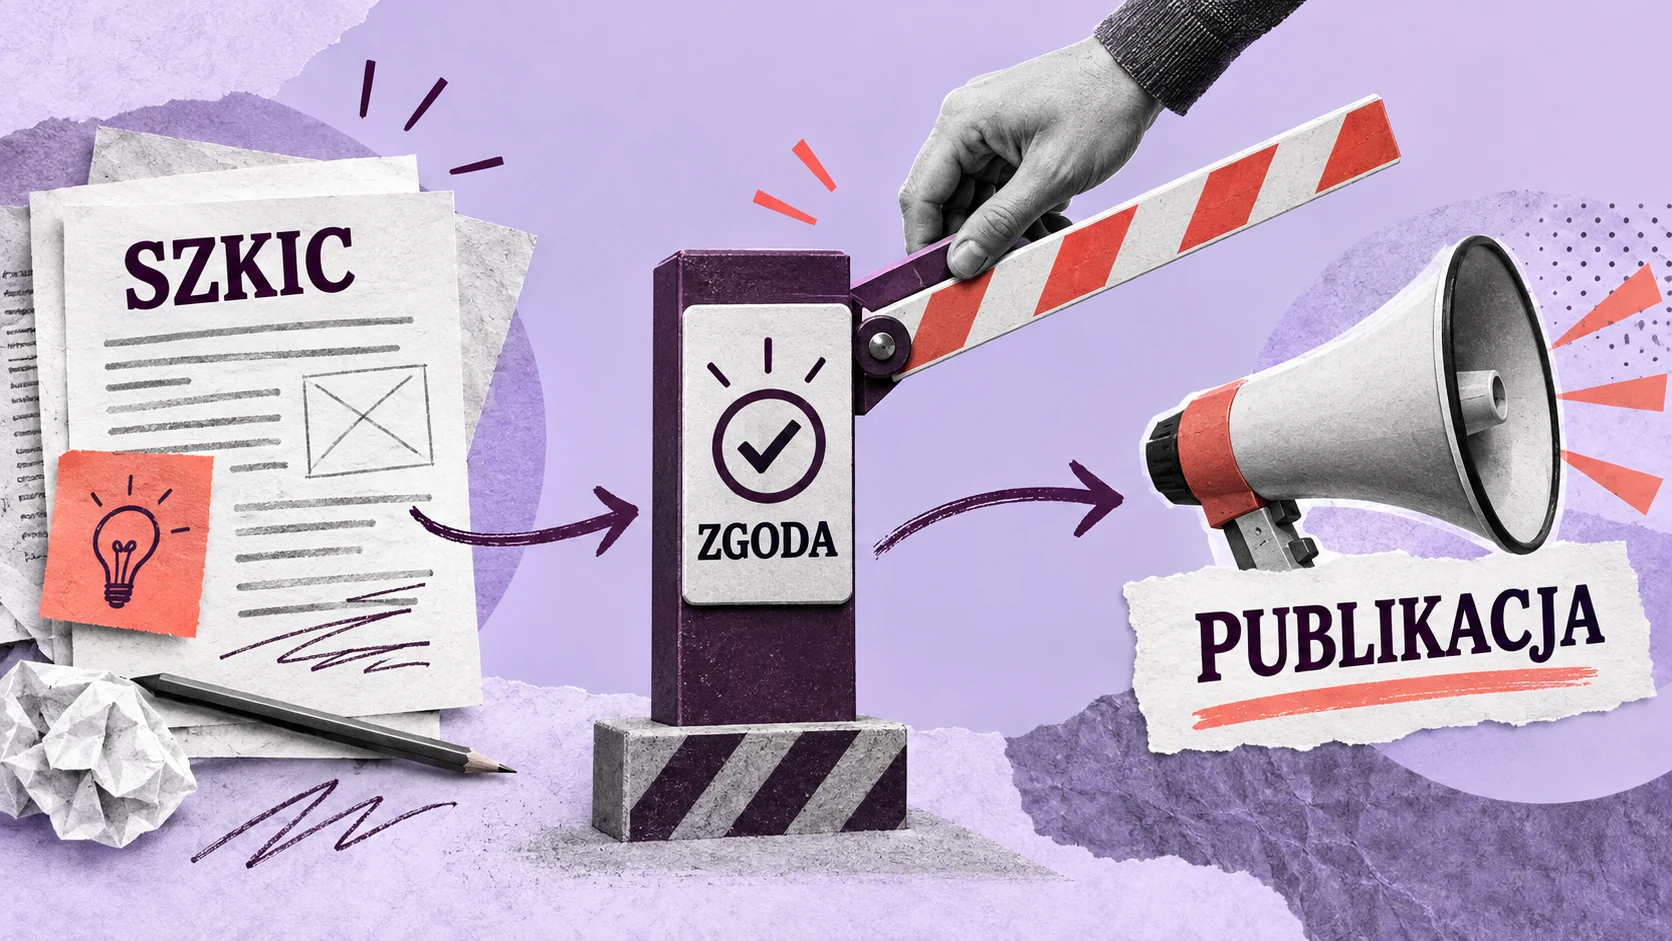
Na potrzeby tego przykładu agent ma prawo czytać materiały i zapisywać szkice, natomiast publikacja wymaga zatwierdzenia. Dzięki temu oceniasz gotową treść i konkretny termin, zanim wpis stanie się publiczny.
Zatwierdzenie powinno odnosić się do sprawdzanej wersji. Jeżeli po akceptacji agent zmieni istotny fragment, wcześniejsza zgoda nie powinna automatycznie obejmować nowej treści. W aplikacji można powiązać decyzję z numerem wersji lub innym identyfikatorem zatwierdzonego dokumentu.
Nie każda czynność wymaga osobnego pytania. Odczyt wcześniej wskazanej dokumentacji może mieścić się w ustalonym zakresie. Wysyłka wiadomości, zmiana konfiguracji produkcyjnej lub publiczna publikacja mają inne skutki i zasługują na osobne reguły. Granice określa właściciel procesu, a aplikacja je egzekwuje.
Bezpieczeństwo: instrukcje nie zastępują ograniczeń
Agent czytający strony, wiadomości lub pliki przetwarza treści, których autorów nie kontrolujesz. W tych materiałach mogą znaleźć się polecenia próbujące wpłynąć na dalsze działanie systemu. Taki problem opisuje OWASP w kategorii prompt injection.
Przykładowo dokument może zawierać zdanie nakazujące przesłanie danych pod wskazany adres. Agent ma traktować je jako zawartość dokumentu, a nie upoważnienie do nowej operacji. Samo dopisanie „ignoruj podejrzane instrukcje” do promptu nie daje jednak gwarancji ochrony.
Dlatego ograniczenia powinny istnieć również poza modelem. W dokumentacji Google ADK dotyczącej bezpieczeństwa omówiono między innymi uwierzytelnianie narzędzi, ograniczanie uprawnień i udział człowieka w zatwierdzaniu działań.
Przy projektowaniu własnego procesu sprawdź przede wszystkim:
- Zakres konta: czy integracja może tylko odczytywać dane lub tworzyć szkice, jeśli tyle wymaga zadanie?
- Dostęp do danych: czy narzędzie zwraca wyłącznie dokumenty potrzebne w danej sprawie?
- Operacje zewnętrzne: czy aplikacja kontroluje miejsca, do których wolno wysyłać informacje?
- Zatwierdzanie zmian: czy operacja wymaga odpowiedniej zgody również wtedy, gdy model spróbuje wywołać ją bezpośrednio?
- Rejestr działań: czy można sprawdzić, co wywołano i jaki był wynik, bez zapisywania sekretów w logach?
Szczególnie szeroki dostęp do powłoki systemowej powinien skłonić do dokładnego sprawdzenia granic środowiska. Narzędzie, które potrafi wykonać dowolne polecenie na produkcji, ma zupełnie inny zakres skutków niż integracja odczytująca pojedynczy dokument.
Jeśli narzędzia agenta działają na twojej infrastrukturze, zapoznaj się z zakresem odpowiedzialności przy własnym VPS-ie. Izolację procesu i jej ograniczenia omawiam też w wprowadzeniu do Dockera.
Jak sprawdzić, czy agent rzeczywiście pomaga
Płynny opis wykonanej pracy jest słabą miarą skuteczności. Potrzebujesz zestawu zadań z warunkami poprawnego zakończenia. Dokumentacja ewaluacji w Google ADK rozróżnia ocenę końcowej odpowiedzi i przebiegu użycia narzędzi. Obie perspektywy są przydatne, choć do tego samego poprawnego wyniku mogą prowadzić różne ścieżki.
W przykładzie blogowym sprawdzaj zapisany wpis, jego status, kompletność wymaganych pól i zgodność źródeł. Dodaj sytuacje trudniejsze: niedostępna dokumentacja, brak uprawnienia do zapisu, sprzeczne dane i przerwane połączenie po wysłaniu żądania.
Ostatni przypadek jest ważny. Brak odpowiedzi nie zawsze oznacza, że zapis się nie odbył. Ponowienie operacji bez sprawdzenia może utworzyć drugi wpis. Projektując integrację, przewidź identyfikator zadania i sposób rozpoznania już wykonanej operacji.
Zapisuj czas, liczbę wywołań i koszt wykonania zadania, jeśli używane usługi pozwalają go ustalić. Osobno odnotuj czas potrzebny człowiekowi na kontrolę i poprawki. Proces trwający minutę, ale wymagający później długiego prostowania błędów, może być mniej użyteczny niż prostszy workflow.
Nie ma jednej uniwersalnej ceny agenta. Koszt zależy między innymi od modelu, ilości przetwarzanej treści, narzędzi oraz ponowień. Przed uruchomieniem ustal limit czasu i liczby kroków, a także budżet tam, gdzie da się go egzekwować. Zatrzymanie po osiągnięciu limitu powinno pozostawiać czytelną informację o stanie zadania.
Od jakiego zadania zacząć
Dobry pierwszy proces ma jasno określony rezultat i ograniczone skutki błędu. Przykładem jest przygotowanie szkicu na podstawie wskazanych dokumentów lub zebranie informacji o problemie bez prawa do zmiany konfiguracji.
Zacznij od ustalenia, co konkretnie będzie oznaczało sukces. Następnie wybierz niezbędne narzędzia i minimalne uprawnienia. Dopiero po sprawdzeniu zwykłych oraz błędnych scenariuszy rozszerzaj zakres działania.
Jeżeli wszystkie kroki potrafisz opisać prostą, stałą sekwencją, najpierw rozważ zwykłą automatyzację. Agent jest uzasadniony tam, gdzie wybór kolejnego kroku zależy od informacji odkrywanych w trakcie pracy. O przydatności decyduje poprawnie wykonane zadanie i koszt kontroli, nie sama etykieta „agent”.
Najczęstsze pytania
Co to jest agent AI?
Agent AI to system, który realizuje cel, dobierając kolejne działania w wyznaczonych granicach. W rozwiązaniach opartych na LLM model może wybierać narzędzia, analizować ich wyniki i wskazywać następne kroki. Rzeczywiste operacje wykonuje aplikacja obsługująca te narzędzia.
Czym agent AI różni się od chatbota?
Prosty chatbot przede wszystkim tworzy odpowiedzi. Agent może prowadzić wieloetapową pracę i reagować na wyniki działań. To rozróżnienie dotyczy sposobu działania: aplikacja z interfejsem czatu również może zawierać agenta.
Czy automatyzacja z modelem AI jest agentem?
Nie zawsze. Jeżeli model wykonuje jeden etap procesu, którego przebieg określa kod, jest to workflow z AI. O architekturze agentowej można mówić wtedy, gdy model dynamicznie dobiera kolejne działania w ramach przyznanych możliwości.
Czy agent AI może pracować bez zgody człowieka?
Może wykonywać wcześniej dozwolone operacje, jeśli aplikacja na to pozwala. Zakres samodzielności jest decyzją projektową. W przykładzie z artykułu odczyt i zapis szkicu są dozwolone, a publikacja wymaga zatwierdzenia konkretnej wersji.
Jak sprawdzić, czy agent wykonał zadanie?
Sprawdź wynik w systemie docelowym: zapisany dokument, status wpisu lub rezultat testu. Porównaj go z warunkami zadania i rejestrem wywołań narzędzi. Deklaracja w rozmowie nie wystarcza do potwierdzenia operacji.
Kiedy lepiej wybrać zwykłą automatyzację?
Gdy kroki są znane, dane mają przewidywalną strukturę i nie trzeba na bieżąco wybierać sposobu rozwiązania problemu. Ustalony workflow ogranicza liczbę decyzji powierzanych modelowi oraz ułatwia sprawdzanie zachowania procesu.
Źródła
- What are AI agents?, Google Cloud.
- Building effective agents, Anthropic.
- Writing effective tools for agents, Anthropic.
- MCP Architecture overview, Model Context Protocol.
- Safety and Security for AI Agents, Google ADK.
- LLM01: Prompt Injection, OWASP.
- Why Evaluate Agents, Google ADK.
Data publikacji: 25.09.2026.
Dyskusja