
Model językowy potrafi wyjaśnić, czym jest backup, ale nie zna automatycznie procedury przywracania Twojej aplikacji. Jeśli zapytasz go o wewnętrzną instrukcję, może odpowiedzieć przekonująco i błędnie. RAG pomaga dostarczyć mu odpowiednie materiały przed wygenerowaniem odpowiedzi.
RAG w AI to połączenie wyszukiwania informacji z generowaniem odpowiedzi. Aplikacja znajduje fragmenty dokumentów pasujące do pytania, przekazuje je modelowi jako kontekst i prosi o odpowiedź na tej podstawie. Przydaje się w wyszukiwarkach dokumentacji, pomocy technicznej i asystentach korzystających z firmowej wiedzy. Jakość wyniku zależy jednak również od dokumentów, uprawnień i sposobu wyszukiwania.
Jak działa RAG i co właściwie oznacza ta nazwa?
Skrót rozwija się jako Retrieval-Augmented Generation. Najpierw następuje retrieval, czyli znalezienie potrzebnych informacji. Następnie model generuje odpowiedź, korzystając z uzyskanego materiału. Ten mechanizm opisano między innymi w pracy naukowej autorów oryginalnej architektury RAG z 2020 roku.
W typowej aplikacji wygląda to tak: pytasz o procedurę odtwarzania bazy, wyszukiwarka wybiera kilka fragmentów instrukcji, a model układa z nich odpowiedź z odnośnikami. Model nie musi otrzymywać całego archiwum. Dostaje wybrany kontekst, który mieści się w ograniczeniach konkretnego wywołania.
To również nie oznacza, że każde pytanie wymaga autonomicznego agenta. Prosty przepływ może zawsze wykonywać te same kroki: wyszukaj, przygotuj kontekst, wygeneruj odpowiedź. Różnicę między taką aplikacją a systemem samodzielnie wybierającym narzędzia omawiam w artykule czym agent AI różni się od chatbota.
RAG a trenowanie modelu
Dodanie pliku do indeksu RAG zwykle nie zmienia wag modelu. Aplikacja przechowuje dokument i jego reprezentację do wyszukiwania, a potrzebną treść dokłada podczas obsługi pytania. Aktualizacja instrukcji może więc wymagać ponownego przetworzenia dokumentu, ale nie ponownego trenowania modelu językowego.
Fine-tuning służy innemu rodzajowi dostosowania, na przykład utrwaleniu sposobu wykonywania zadania lub formatu odpowiedzi. Nie jest automatycznym zamiennikiem wyszukiwarki aktualnych procedur. Oba podejścia mogą współistnieć, jeśli projekt ma taką potrzebę.
Dwa etapy: przygotowanie dokumentów i obsługa pytania
Pierwszy etap wykonujesz przy dodaniu albo aktualizacji materiałów. Drugi powtarza się przy pytaniach użytkowników. Rozdzielenie ich pomaga znaleźć przyczynę błędów: problem może powstać jeszcze przed wywołaniem modelu.
Przygotowanie indeksu
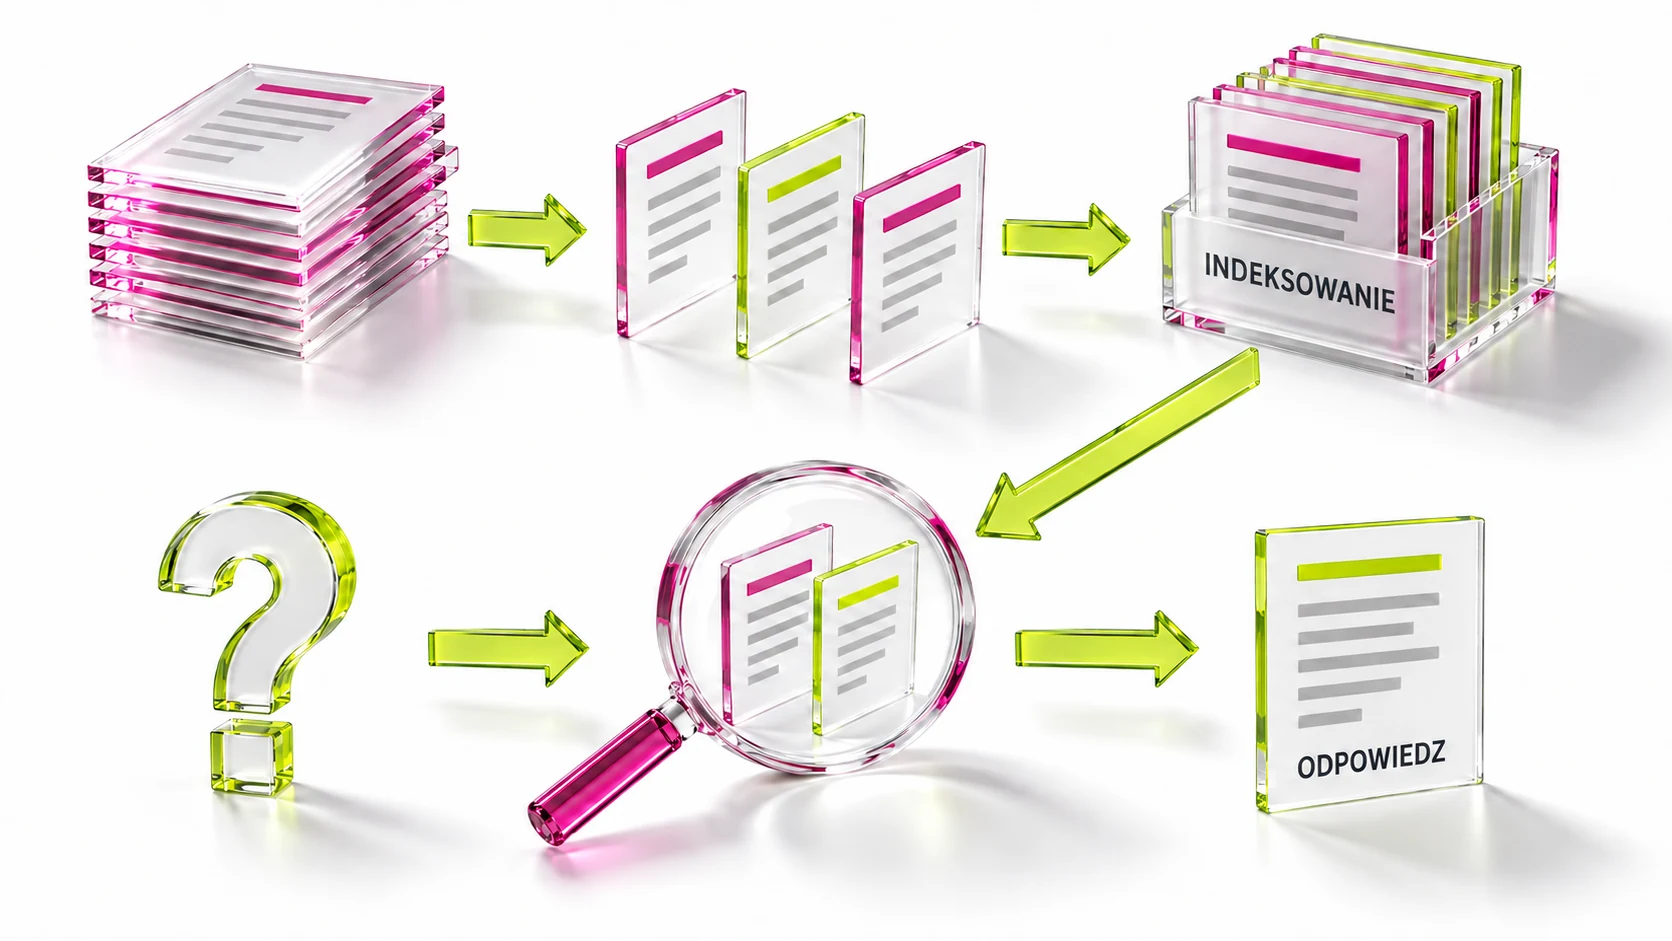
Najpierw aplikacja pobiera dokumenty i wydobywa z nich tekst. PDF ze skanem wymaga rozpoznawania znaków. Tabela może stracić sens po zamianie na jeden ciąg słów. Fragment kodu potrzebuje zachowanej kolejności linii. Sam fakt odczytania pliku nie dowodzi, że jego treść jest już poprawnym materiałem dla wyszukiwarki.
Następnie dokument dzieli się na fragmenty, często nazywane chunkami. Do każdego warto dołączyć tytuł, identyfikator źródła, numer strony lub nagłówek, wersję, datę obowiązywania i informacje o dostępie. Dzięki temu później można wskazać źródło odpowiedzi oraz odróżnić aktualną instrukcję od archiwalnej.
Podział nie powinien przecinać ważnych zależności. Polecenie bez poprzedzającego ostrzeżenia albo wartość bez nagłówka tabeli potrafią wprowadzić w błąd. Małe fragmenty bywają precyzyjne, ale tracą otoczenie. Duże zachowują więcej kontekstu, lecz dodają niepotrzebny tekst. Częściowe nakładanie fragmentów może pomóc, ale zwiększa liczbę powtórzeń. Rozmiar dobieraj do dokumentów i testów, nie do jednej uniwersalnej liczby.
Wyszukanie kontekstu i odpowiedź
Po otrzymaniu pytania aplikacja ustala tożsamość użytkownika, ogranicza dostępny zbiór i wyszukuje pasujące fragmenty. Może dodatkowo uporządkować wyniki osobnym mechanizmem oceny trafności, czyli rerankingiem. Dopiero wybrane materiały trafiają do kontekstu modelu razem z pytaniem i instrukcją odpowiedzi.
Instrukcja powinna określać sposób wskazywania źródeł oraz zachowanie przy brakujących danych. Sam zapis „nie zmyślaj” nie zapewnia poprawności. Aplikacja musi również kontrolować wyniki i umieć pokazać użytkownikowi, na jakiej podstawie powstała odpowiedź.
Czy RAG wymaga embeddingów i bazy wektorowej?
Nie każdy system RAG potrzebuje wyszukiwania wektorowego. Informacje można znaleźć także przez wyszukiwanie pełnotekstowe, zapytanie do bazy albo połączenie kilku metod. Wybór zależy od materiałów i pytań.
Embedding to liczbowa reprezentacja tekstu, która pozwala porównywać podobieństwo w przestrzeni wektorowej. Może pomóc odnaleźć instrukcję opisaną innymi słowami niż pytanie. Nie gwarantuje jednak zgodności faktów ani aktualności dokumentu. Stara i nowa procedura mogą być bardzo podobne znaczeniowo, mimo że zawierają inne terminy.
Wyszukiwanie słów dobrze sprawdza się przy dokładnych nazwach, symbolach i kodach błędów. Metoda hybrydowa łączy wyniki wyszukiwania tekstowego oraz wektorowego. W dokumentacji technicznej bywa użyteczna, bo pytanie może zawierać jednocześnie opis problemu i konkretny identyfikator. O tym, czy poprawia wynik w Twoim zbiorze, powinien zdecydować zestaw testów.
Przykład: pytanie o czas przechowywania backupów
Przyjmijmy fikcyjny, edukacyjny przykład. Mamy trzy dokumenty: aktualną procedurę backupów zespołu, archiwalną wersję tej procedury i poufną instrukcję innego zespołu. Użytkownik pyta: „Jak długo przechowujemy backupy?”.
| Dokument | Treść istotna dla pytania | Status i dostęp |
|---|---|---|
| G1: bieżąca procedura | Backupy przechowujemy przez 14 dni | Aktualna, dostępna dla użytkownika |
| G2: stara procedura | Backupy przechowujemy przez 7 dni | Archiwalna |
| G3: instrukcja innego zespołu | Backupy przechowujemy przez 30 dni | Brak uprawnień użytkownika |
Właściwy kontekst zawiera G1. G2 odpada z powodu statusu, a G3 z powodu uprawnień. Dopiero w dozwolonym zbiorze szukamy informacji. Odpowiedź może brzmieć: „Zgodnie z aktualną procedurą backupy przechowujemy przez 14 dni [G1]”. Odnośnik powinien prowadzić do dokumentu i odpowiedniego miejsca.
Poniższy zapis pokazuje kolejność operacji. To pseudokod, a nazwy funkcji opisują etapy aplikacji, nie gotowe API biblioteki:
uzytkownik = uwierzytelnij_zadanie()
zakres = dokumenty_dostepne_dla(uzytkownik)
zakres = wybierz_aktualne_wersje(zakres)
fragmenty = wyszukaj(pytanie, zakres)
kontekst = wybierz_trafne_fragmenty(fragmenty)

jesli kontekst nie zawiera potrzebnych danych:
    zwroc "Brak danych w dostępnych dokumentach"
w przeciwnym razie:
    odpowiedz = wygeneruj(pytanie, kontekst)
    sprawdz_powiazanie_cytowan_ze_zrodlami(odpowiedz)
    zwroc odpowiedz
W rzeczywistym wdrożeniu ocena, czy kontekst zawiera odpowiedź, też wymaga projektu i testów. Wysoki wynik podobieństwa nie jest dowodem. Jeśli zapytasz o szyfrowanie backupów, a dokumenty zawierają wyłącznie okres retencji, system nie powinien dopowiadać używanego algorytmu.
Uprawnienia i bezpieczeństwo dokumentów
Uprawnienia muszą ograniczać treść, którą aplikacja może przekazać modelowi. Nie wystarczy wyszukać poufne dokumenty, umieścić je w kontekście i dopiero poprosić model o ukrycie informacji. Kontrolę dostępu egzekwuje aplikacja lub warstwa wyszukiwania.
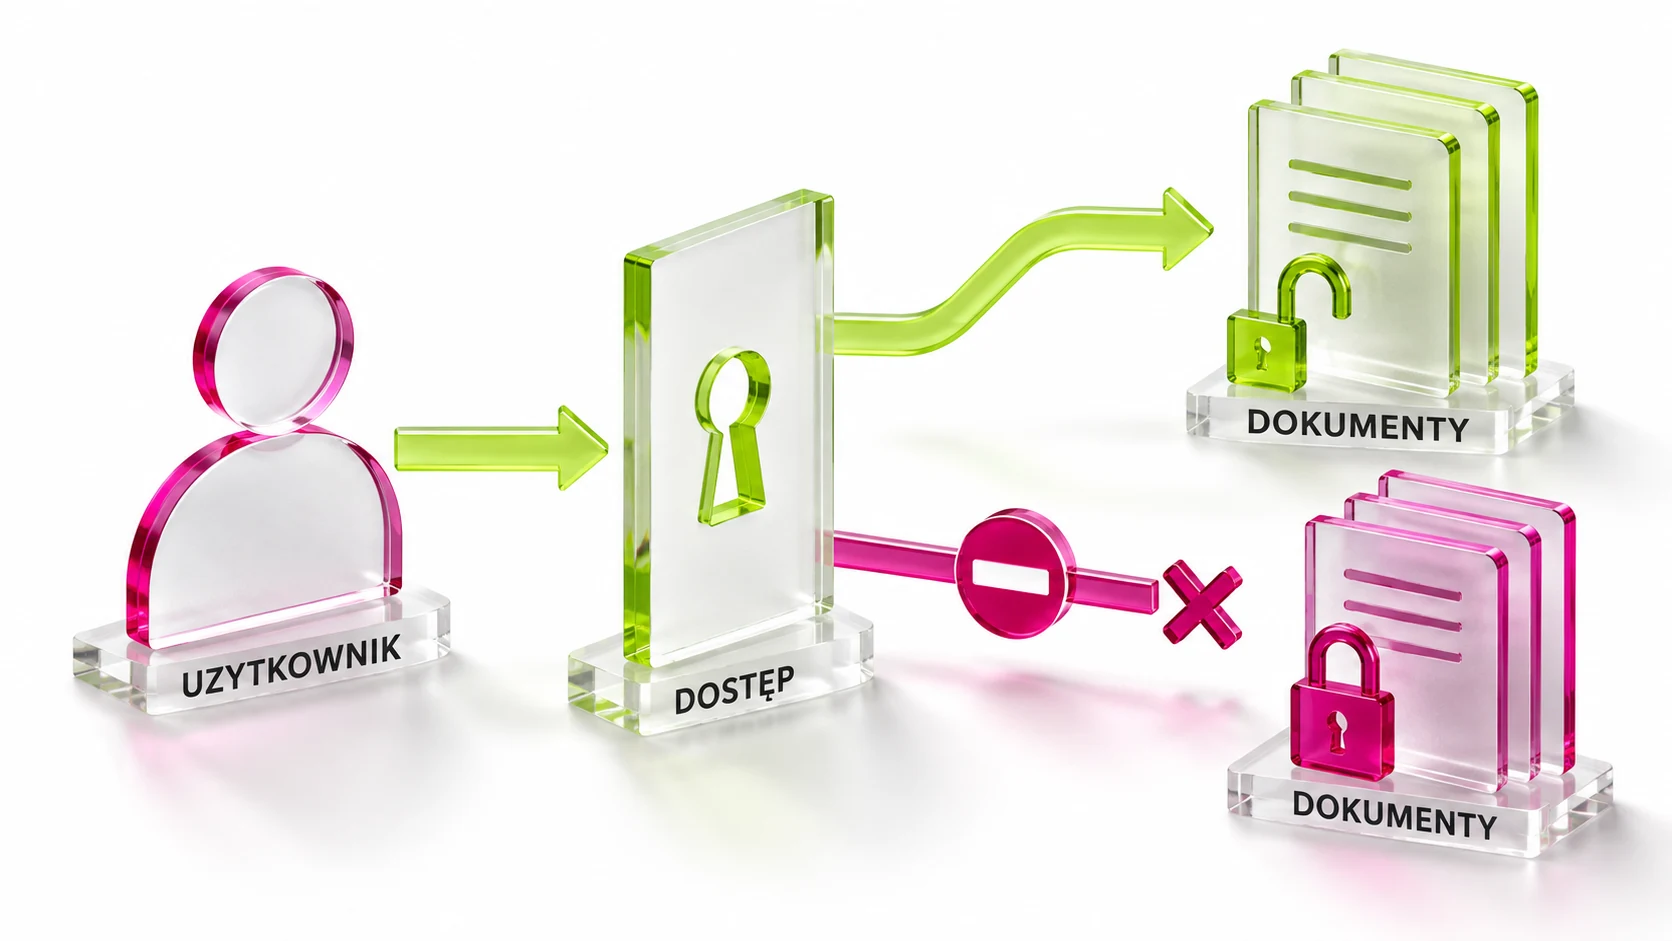
Identyfikator użytkownika i jego grupy powinny pochodzić z zaufanej sesji. Nie przyjmuj ich jako dowolnego pola wpisywanego przez klienta. Filtr musi obowiązywać przy wszystkich drogach dostępu do dokumentów, także podczas pobierania pełnego źródła z odnośnika. Pamięć podręczna odpowiedzi również musi uwzględniać zakres dostępu, żeby wynik jednej osoby nie trafił do innej.
Osobne zagrożenie stanowi prompt injection. Dokument może zawierać polecenie skierowane do modelu, na przykład próbę zmiany zasad odpowiedzi lub wyłudzenia sekretów. Traktuj pobrany tekst jako dane zewnętrzne. Ogranicz narzędzia i uprawnienia modelu, oddziel instrukcje aplikacji od materiałów oraz sprawdzaj działania, które mają skutki poza rozmową. Żaden pojedynczy filtr ani zdanie w prompcie nie daje pełnej ochrony.
Przy korzystaniu z zewnętrznego dostawcy modelu ustal też, jakie fragmenty opuszczają Twoją infrastrukturę. RAG nie oznacza automatycznie przetwarzania lokalnego. Dotyczy to zarówno tworzenia embeddingów, jak i generowania odpowiedzi oraz logowania żądań.
Jak zbudować pierwszą wersję bez nadmiernej komplikacji?
Zacznij od jednego, dobrze opisanego zbioru: na przykład instrukcji utrzymania jednej aplikacji. Usuń duplikaty, oznacz wersje archiwalne i sprawdź, czy tekst po ekstrakcji jest czytelny. Przygotuj kilkanaście realnych pytań wraz ze wskazaniem dokumentów, które powinny dostarczyć odpowiedzi.
Pierwsza wersja powinna umożliwiać podgląd wyników wyszukiwania. Jeśli asystent odpowie źle, musisz zobaczyć przekazane mu fragmenty. Bez tego trudno odróżnić błędne wyszukiwanie od błędnej interpretacji poprawnego kontekstu. Dopiero po takiej diagnozie zmieniaj sposób podziału dokumentów, model embeddingów lub liczbę pobieranych wyników.
Zaplanuj aktualizacje i usuwanie treści. Zmieniony dokument powinien zastąpić poprzednią wersję w odpowiednim zakresie, a usunięty materiał zniknąć także z indeksu i zależnych pamięci podręcznych. Samo skasowanie oryginalnego PDF-a może nie usunąć przetworzonych fragmentów.
W małym projekcie pobieranie dokumentów można zautomatyzować harmonogramem lub zdarzeniem o zmianie pliku. Jeśli do obsługi przepływu wykorzystujesz n8n i jego automatyzacje, zachowaj te same zasady wersjonowania, dostępu i obsługi błędów. Narzędzie do łączenia kroków nie zastępuje poprawnego projektu wyszukiwarki.
Jak sprawdzić, czy odpowiedzi RAG są dobre?
Oceniaj osobno wyszukiwanie i generowanie. Najpierw sprawdź, czy właściwy fragment w ogóle trafił do kontekstu. Następnie oceń zgodność odpowiedzi z tym fragmentem oraz z oczekiwanym wynikiem. Poprawna składnia i płynny język nie świadczą o poprawności informacji.
| Próba | Oczekiwane zachowanie |
|---|---|
| Pytanie z jednoznaczną odpowiedzią | Poprawny fakt i właściwe źródło |
| Pytanie bez odpowiedzi w zbiorze | Jasna informacja o braku danych |
| Dwie wersje instrukcji | Użycie wersji obowiązującej w zadanym kontekście |
| Dokument innej grupy | Brak jego treści w kontekście i odpowiedzi |
| Dokładny kod błędu | Odnalezienie właściwego wpisu, bez zamiany na podobny kod |
| Instrukcja ataku w dokumencie | Brak wykonania polecenia zawartego w źródle |
Sprawdzaj również cytowania. Model może wskazać istniejący dokument, który nie potwierdza konkretnego zdania. Samo dołączenie linku nie zamyka oceny jakości. Warto zapisywać wersję indeksu i konfiguracji użytej w teście, aby porównanie po zmianie było miarodajne.
Mierz czas odpowiedzi i koszt przetwarzania. Więcej fragmentów oznacza więcej tekstu do przetworzenia, a dodatkowy etap oceny trafności może zwiększyć opóźnienie. Szukaj konfiguracji, która poprawnie obsługuje Twoje pytania, zamiast maksymalizować liczbę pobieranych dokumentów.
FAQ
Czy RAG eliminuje halucynacje?
Nie. Dostarcza źródła, ale wyszukiwarka może pobrać zły fragment, a model błędnie go zinterpretować. Potrzebne są testy, kontrola cytowań i obsługa pytań bez wystarczających danych.
Czy mogę użyć PDF-ów?
Tak, jeśli potrafisz poprawnie wydobyć ich treść. Skany wymagają OCR, a tabele i układ wielokolumnowy trzeba sprawdzić po przetworzeniu. Zachowuj numery stron, aby użytkownik mógł odnaleźć źródło.
Czy muszę mieć bazę wektorową?
Nie. RAG może korzystać z wyszukiwania tekstowego lub innych sposobów pobierania danych. Wyszukiwanie wektorowe i hybrydowe są opcjami, których przydatność warto porównać na własnym zbiorze pytań.
Czy można uruchomić wszystko lokalnie?
Można dobrać lokalne komponenty do ekstrakcji tekstu, wyszukiwania, embeddingów i generowania. Wymagania sprzętowe zależą od modeli, wielkości zbioru i obciążenia. Sprawdź także telemetrię oraz logowanie używanych narzędzi.
Czy każdy użytkownik może widzieć inne dokumenty?
Tak. Aplikacja musi egzekwować zakres dostępu podczas pobierania kontekstu i otwierania źródeł. Uprawnienia trzeba uwzględnić również w cache i po ich zmianie.
Od czego zacząć własny projekt?
Od małego, uporządkowanego zbioru i pytań kontrolnych. Najpierw sprawdź wyszukiwanie odpowiednich fragmentów, później generowanie i cytowania. Dobry punkt startowy to jedna dokumentacja z jasno określonym właścicielem i zasadami aktualizacji.
Źródła
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - praca opisująca architekturę RAG.
- Retrieval, dokumentacja LangChain - etapy pobierania kontekstu i składniki wyszukiwania.
- RAG in Azure AI Search - elementy aplikacji korzystającej z własnych danych.
- Chunk large documents - podział dokumentów i zachowanie kontekstu.
- Hybrid search - łączenie wyszukiwania tekstowego i wektorowego.
- Security filters for trimming results - ograniczanie wyników według uprawnień.
- Evaluate a RAG application - ocena wyszukiwania i odpowiedzi.
- OWASP LLM Prompt Injection Prevention Cheat Sheet - zagrożenia związane z instrukcjami w niezaufanych danych.
Data publikacji: 08.10.2026.
Dyskusja