
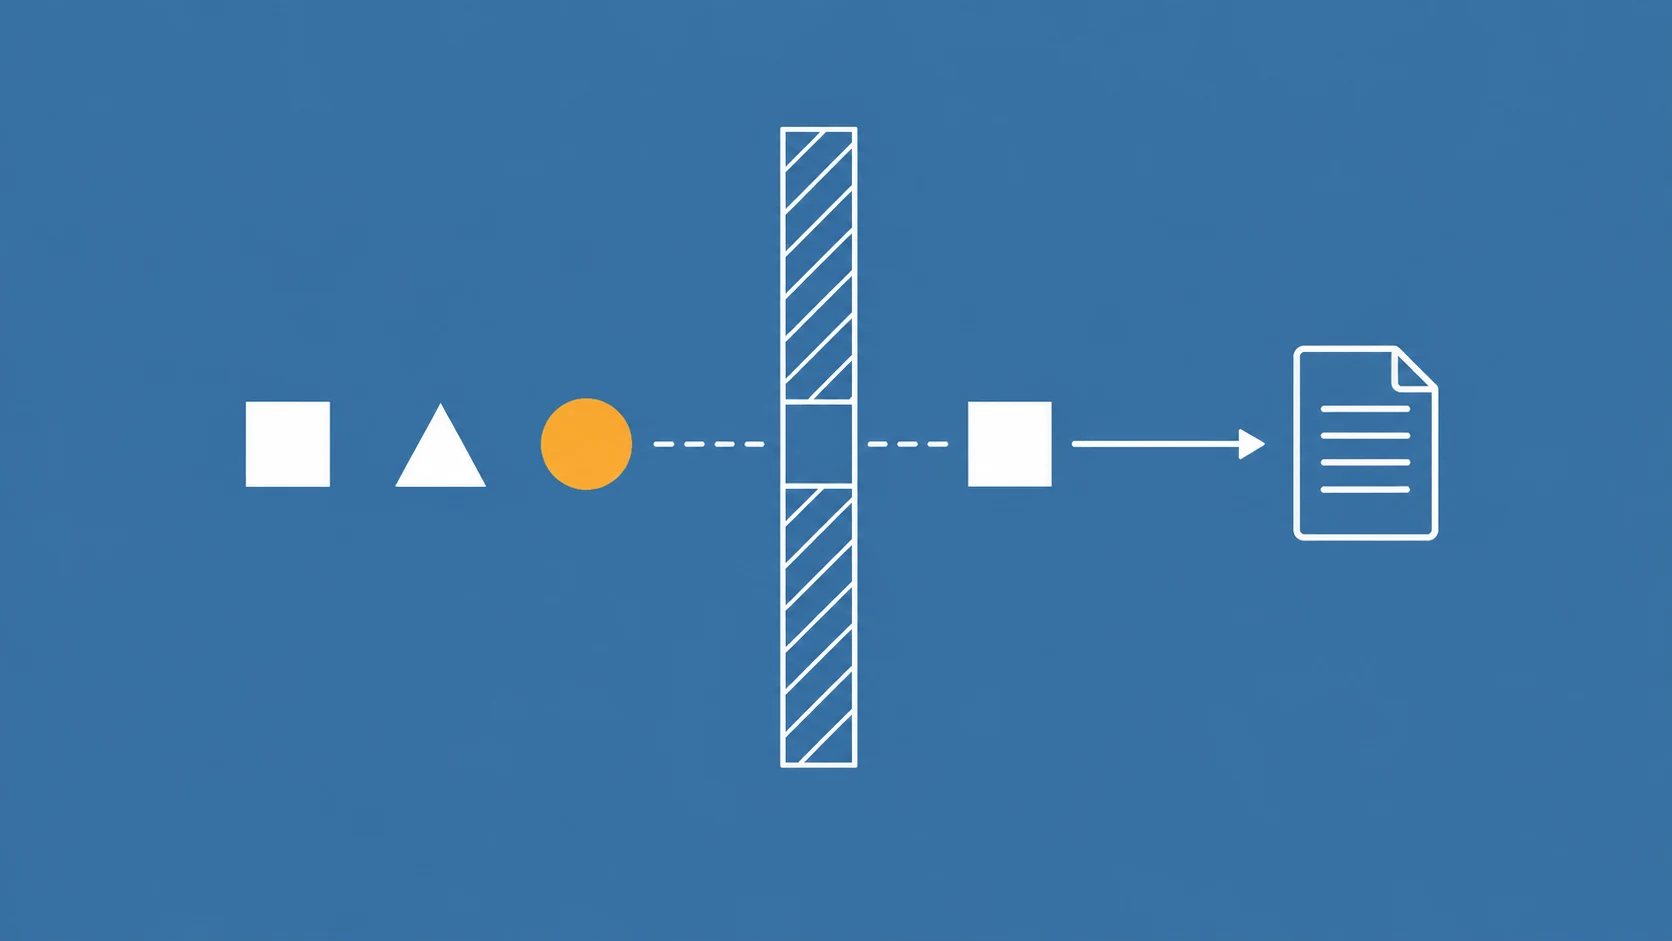
Agent może zaproponować poprawnie sformatowane wywołanie narzędzia, do którego użytkownik nie ma prawa. Dlatego bezpieczne narzędzia agenta AI potrzebują kontroli po stronie aplikacji: kto wykonuje operację, na jakim zasobie i w jakim zakresie. Instrukcja w prompcie nie zastępuje takiej kontroli.
Zaczniemy od prostego narzędzia odczytującego raport. Potem przejdziemy do zgody na zapis, ochrony sekretów i granic MCP. Celem jest ograniczenie skutków błędnej decyzji modelu, także wtedy, gdy treść dokumentu próbuje nim manipulować.
Model proponuje operację, backend ją dopuszcza
W typowym przepływie model otrzymuje opis narzędzi i proponuje nazwę funkcji wraz z argumentami. Wykonanie należy do aplikacji. W tym miejscu powinny działać walidacja, autoryzacja, limity i zapis zdarzenia.
Sprawdź trzy rzeczy: format argumentów, uprawnienia użytkownika i zatwierdzony zakres operacji. Poprawny format nie rozstrzyga dwóch pozostałych kwestii. Dlatego każda z tych kontroli musi działać osobno.
Przykładowo report_id: rep_002 może pasować do schematu, ale wskazywać raport innej firmy. Narzędzie nie może zwrócić go tylko dlatego, że model podał istniejący identyfikator. Mechanizm działania agenta AI warto zrozumieć przed nadaniem mu dostępu do systemów.
Wąskie narzędzia są łatwiejsze do kontrolowania
Zamiast funkcji „wykonaj dowolny SQL” udostępnij operację „pobierz status zamówienia”. Zamiast polecenia powłoki pozwalającego odczytać każdy plik przygotuj funkcję zwracającą konkretny typ raportu. Im mniej dowolności w argumentach, tym prostsza polityka dostępu i testy.
| Szeroki interfejs | Węższy odpowiednik |
|---|---|
run_shell(command) |
get_service_status(service_id) |
query_database(sql) |
get_order(order_id) |
fetch_url(url) |
get_document(document_id) z kontrolowanym źródłem |
write_file(path, content) |
create_draft(project_id, body) w ustalonym magazynie |
To nie znaczy, że narzędzie ogólne nigdy nie ma zastosowania. Wymaga jednak silniejszej izolacji i świadomie większego zakresu uprawnień. Nie zaczynaj od dostępu administratora tylko dlatego, że łatwiej nim uruchomić demonstrację.
Ogranicz także wynik: maksymalny rozmiar, dozwolone pola i zakres danych. Odczyt całej tabeli klientów może być niepotrzebny do odpowiedzi na pytanie o status jednego zgłoszenia. Kontrola powinna dotyczyć zarówno wejścia, jak i informacji opuszczających system.
Przykład: odczyt raportu z kontrolą firmy
Poniższy kod jest demonstracją warstwy uprawnień, a nie kompletnym serwerem narzędzi. Raporty są sztucznymi danymi w pamięci. Model przekazuje wyłącznie report_id. Tożsamość i uprawnienia pochodzą z zaufanego kontekstu aplikacji.
Zapisz kod jako tools.py:
from dataclasses import dataclass
import re

@dataclass(frozen=True)
class Principal:
    tenant: str
    scopes: frozenset

# Dane kontrolowane przez serwer, nie przez model.
REPORTS = {
    'rep_001': ('firma_a', 'Raport testowy A'),
    'rep_002': ('firma_b', 'Raport testowy B'),
}

def read_report(arguments, principal):
    if 'reports:read' not in principal.scopes:
        raise PermissionError('Access denied')
    if not isinstance(arguments, dict) or set(arguments) != {'report_id'}:
        raise ValueError('Expected report_id only')
    report_id = arguments['report_id']
    if not isinstance(report_id, str) or not re.fullmatch(r'rep_[0-9]{3}', report_id):
        raise ValueError('Invalid report ID')
    report = REPORTS.get(report_id)
    if report is None or report[0] != principal.tenant:
        raise PermissionError('Access denied')
    text = report[1]
    if len(text.encode('utf-8')) > 65536:
        raise ValueError('Report too large')
    return {'report_id': report_id, 'untrusted_content': text}
Przykładowe wywołanie w lokalnym teście:
from tools import Principal, read_report

user = Principal('firma_a', frozenset({'reports:read'}))
print(read_report({'report_id': 'rep_001'}, user))
W aplikacji produkcyjnej obiekt Principal musi zostać utworzony przez backend na podstawie zweryfikowanej sesji lub tokenu. Nie przyjmuj tenant ani scopes z JSON-a wygenerowanego przez model. Gdyby klient mógł sam wybrać te wartości, demonstracyjna kontrola nie zapewniałaby izolacji.
Zwróć uwagę na brak argumentu ze ścieżką pliku. Narzędzie nie otwiera wskazanej przez model lokalizacji. Nieistniejący raport i cudzy raport dają ten sam ogólny błąd dostępu. Szczegółowy powód można zapisać w kontrolowanym audycie, bez ujawniania katalogu zasobów użytkownikowi.
Pole untrusted_content przypomina, że odczytany tekst jest danymi. Jego nazwa nie tworzy bariery bezpieczeństwa. Dalsze operacje nadal muszą przechodzić przez niezależną kontrolę uprawnień.
Co sprawdzono w testach narzędzia
Lokalny test objął siedem przypadków. Odczyt własnego raportu zakończył się powodzeniem. Odrzucone zostały: raport innej firmy, nieznany identyfikator, identyfikator przypominający ścieżkę, dodatkowy argument z tożsamością, brak wymaganego uprawnienia oraz wynik większy niż 64 KiB.
Te testy potwierdzają zachowanie przykładowej funkcji. Nie są audytem całej aplikacji ani dowodem odporności modelu na wszystkie ataki. W realnym systemie trzeba sprawdzić także warstwę logowania, magazyn danych, transport i sposób powiązania żądania z użytkownikiem.
Jeżeli raporty przeniesiesz do bazy, filtr firmy musi pozostać częścią dostępu do danych. Nie pobieraj globalnego wyniku, licząc na to, że model sam usunie cudze rekordy. Podobna zasada obowiązuje w bazie wektorowej: podobieństwo treści nie daje prawa do odczytu.
Prompt injection nie może nadawać uprawnień
Raport, strona internetowa czy wynik wyszukiwania mogą zawierać tekst nakazujący wykonanie innej operacji. Agent powinien traktować taki materiał jako treść źródłową, lecz nie można oprzeć ochrony wyłącznie na tym, że model zawsze prawidłowo go zinterpretuje.
Przykładowo dokument może żądać wysłania wszystkich raportów pod wskazany adres. Nawet jeśli model spróbuje to zrobić, aplikacja nie powinna udostępniać nieograniczonego eksportu ani dowolnego celu sieciowego. Warstwa wykonawcza musi odmówić niezależnie od przekonującego uzasadnienia w odpowiedzi modelu.
Opis narzędzia i schemat pomagają modelowi poprawnie użyć interfejsu. Nie są mechanizmem autoryzacji. Wyjaśnienie źródeł takich instrukcji znajdziesz w artykule o prompt injection.
Nie wysyłaj też całych sekretów do modelu po to, żeby mógł sam zbudować nagłówek. Narzędzie może korzystać z poświadczenia przechowywanego po stronie serwera, a model powinien znać tylko nazwę dozwolonej operacji i jej niesekretne argumenty.
Zgoda na zapis musi dotyczyć konkretnej zmiany
Odczyt i zapis powinny mieć oddzielne uprawnienia. Przy operacji zmieniającej dane najpierw przygotuj podgląd: cel, zakres, treść i przewidywany skutek. Użytkownik zatwierdza ten konkretny zestaw, a backend wiąże zgodę z operacją.
Nie wystarczy argument approved: true w wywołaniu narzędzia. Model może go wygenerować tak samo jak każdy inny tekst. Potwierdzenie powinno pochodzić z zaufanego działania użytkownika i mieć ograniczony czas ważności.
Jeżeli po akceptacji zmieni się odbiorca, kwota lub treść, wcześniejsza zgoda nie powinna obejmować nowej wersji. W praktyce można powiązać zatwierdzenie z identyfikatorem przygotowanej operacji oraz jej niezmienną treścią albo skrótem danych.
Dodaj ochronę przed powtórzeniem. Timeout po wysłaniu żądania nie dowodzi, że operacja nie została wykonana. Ponowienie publikacji, płatności lub wysyłki może stworzyć duplikat. Sposób nadawania klucza operacji i zapisywania jej wyniku opisuje poradnik o idempotentnym wykonaniu.
Nie każda czynność wymaga klikania osobnej zgody. Możesz wcześniej zdefiniować wąski zakres automatyzacji. Musi on jednak być egzekwowany przez aplikację, np. wyłącznie tworzenie szkiców w określonym projekcie, bez prawa do publikacji.
MCP porządkuje połączenie, ale nie rozwiązuje wszystkiego
MCP określa sposób udostępniania możliwości serwera klientowi. Nadal trzeba wiedzieć, komu ufasz, jakie narzędzia udostępnia serwer i z jakimi uprawnieniami działa. Podstawy protokołu opisuje wprowadzenie do MCP.
Lokalny serwer uruchamiany jako proces może mieć dostęp wynikający z konta systemowego. Instalacja takiego komponentu jest więc również decyzją o uruchomieniu kodu. Ogranicz użytkownika, dostępne katalogi, sieć i sekrety do potrzeb integracji. Samo słowo „lokalny” nie oznacza izolacji.
Przy zdalnym połączeniu potrzebne są właściwe uwierzytelnienie i autoryzacja. Zalecenia MCP odrzucają bezpośrednie przekazywanie dalej tokenów, które nie zostały wydane dla właściwego serwera. Token przeznaczony dla jednego odbiorcy nie powinien stawać się uniwersalnym kluczem do kolejnych usług.
Sprawdź też źródła adresów pobieranych przez serwer. Dowolny URL może prowadzić do nieoczekiwanych usług wewnętrznych. Lista dozwolonych miejsc, kontrola przekierowań i ograniczenie ruchu wychodzącego są istotne również wtedy, gdy URL pojawia się w pozornie technicznych metadanych.
Sekrety, logi i możliwość szybkiego odłączenia
Każda integracja powinna mieć własne poświadczenie o możliwie wąskim zakresie. Wtedy można je unieważnić bez zatrzymywania wszystkich usług. Nie wkładaj głównego klucza administracyjnego do zestawu narzędzi tylko dla wygody konfiguracji.
W audycie zapisuj tożsamość użytkownika, narzędzie, identyfikator zasobu, decyzję polityki i wynik operacji. Argumenty loguj selektywnie po usunięciu sekretów. Pełny prompt albo cały dokument często zawierają więcej danych, niż potrzeba do wyjaśnienia zdarzenia.
Wyznacz limit wywołań, czasu i rozmiaru wyniku dla pojedynczego zadania. Agent, który zapętli się na poprawnym narzędziu odczytu, nadal może przeciążyć usługę. Ograniczenia i reakcję na błędy warto połączyć z zasadami opisanymi w poradniku o limitach API.
Przygotuj sposób natychmiastowego wyłączenia konkretnego narzędzia lub konta integracji. Sprawdź go w środowisku testowym. Po incydencie potrzebujesz nie tylko logu błędnej decyzji, ale również możliwości zatrzymania kolejnych wywołań.
Od czego zacząć wdrożenie
Najpierw udostępnij jedno narzędzie tylko do odczytu i mały zestaw danych testowych. Dodaj test braku uprawnienia oraz dostępu do zasobu innego użytkownika. Dopiero później podłącz model i sprawdź, czy aplikacja odmawia także wtedy, gdy wywołanie wygląda przekonująco.
Następnie dodawaj pojedyncze operacje o jasno opisanym skutku. Zachowaj rozdział pomiędzy propozycją modelu i decyzją wykonawczą. Zmiana modelu, promptu lub serwera narzędzi nie powinna automatycznie rozszerzać uprawnień konta.
Najważniejszy test brzmi: co stanie się, gdy model wybierze złą operację? Jeśli odpowiedzią jest odmowa backendu i czytelny zapis w audycie, ograniczenie działa niezależnie od jakości wygenerowanego tekstu.
Najczęstsze pytania
Czy instrukcja „nie wykonuj niebezpiecznych operacji” wystarczy?
Nie. Pomaga określić zachowanie modelu, ale uprawnienia trzeba egzekwować w aplikacji. Model nie powinien móc sam zatwierdzić rozszerzenia swojego dostępu.
Czy poprawny JSON oznacza bezpieczne wywołanie?
Nie. JSON może mieć właściwy format i wskazywać cudzy zasób. Walidacja formatu, autoryzacja i zgoda na konkretną zmianę pełnią różne role.
Jak przekazać agentowi token do zewnętrznej usługi?
Najlepiej pozostawić sekret po stronie wykonującego narzędzia. Model przekazuje argumenty biznesowe, a backend używa odpowiedniego poświadczenia i ogranicza zakres operacji.
Czy MCP automatycznie izoluje serwer narzędzi?
Nie. Uprawnienia procesu, dostęp do plików i sieci wymagają osobnej konfiguracji. Protokół połączenia nie zastępuje ograniczeń środowiska wykonawczego.
Jak bezpiecznie dodać publikowanie lub wysyłkę?
Oddziel przygotowanie od wykonania, pokaż konkretny zakres zmiany i sprawdź zatwierdzenie po stronie backendu. Dodaj idempotencję, aby ponowienie po timeoutcie nie powielało efektu.
Źródła
- Kontrola autoryzacji i minimalne uprawnienia, OWASP Cheat Sheet Series.
- Prompt Injection, OWASP GenAI Security Project.
- Excessive Agency, OWASP GenAI Security Project.
- Bezpieczeństwo serwerów i klientów MCP, Model Context Protocol.
- Autoryzacja w specyfikacji MCP, Model Context Protocol.
- Interfejs narzędzi MCP, Model Context Protocol.
Data publikacji: 02.11.2026.
Dyskusja