
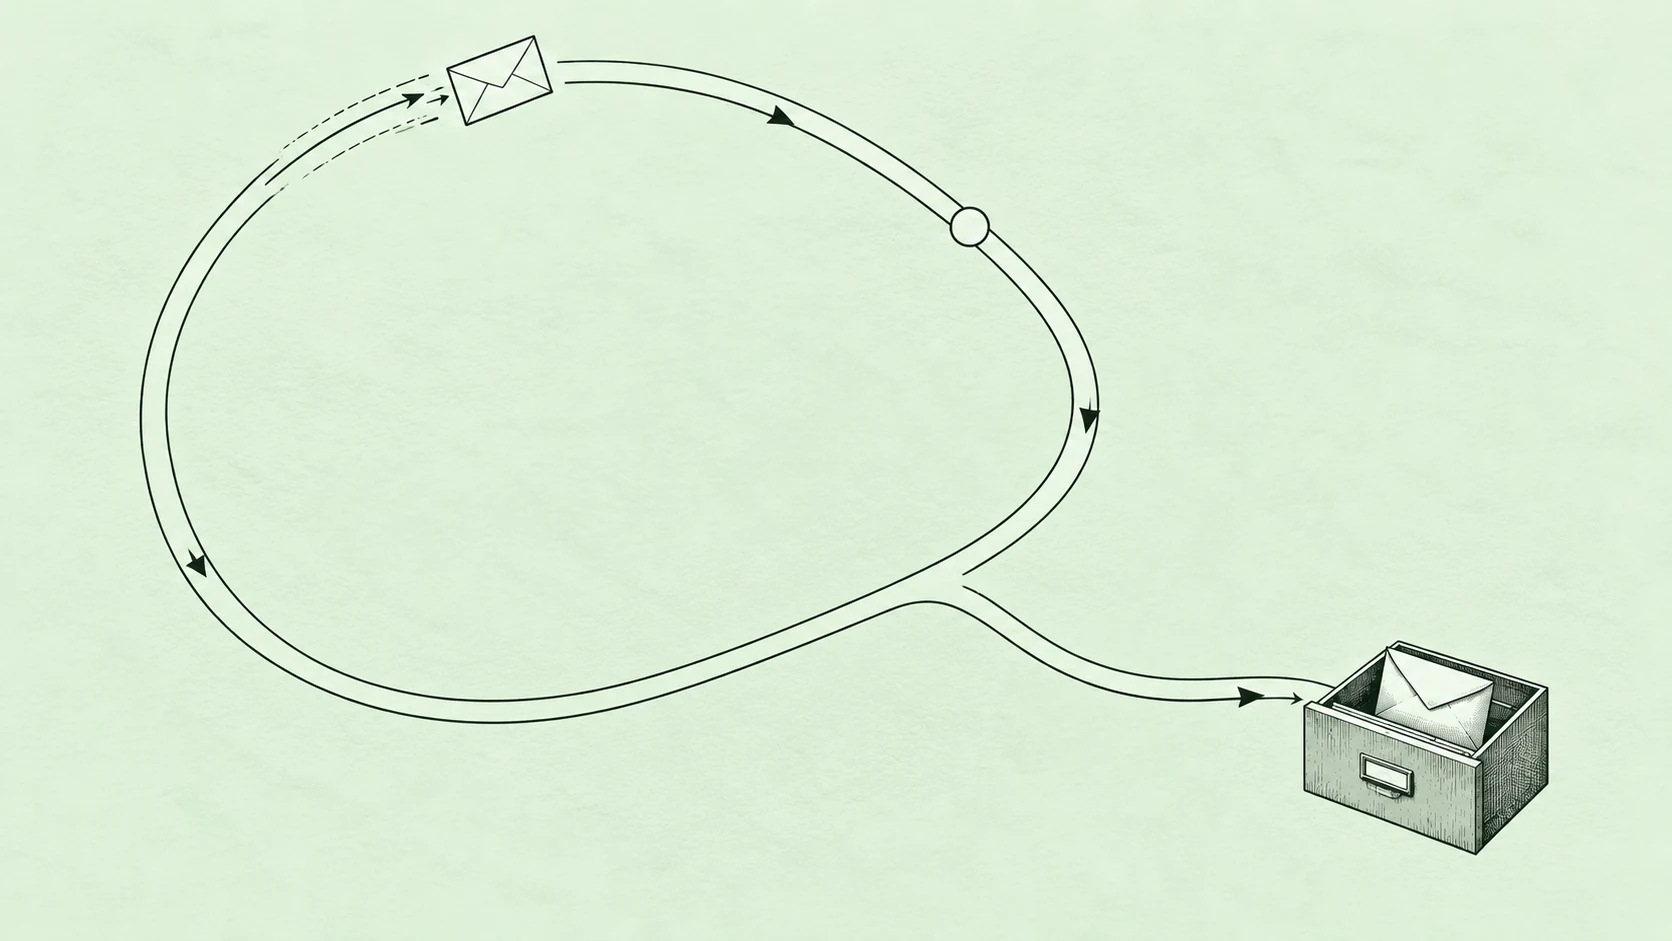
Timeout nie mówi, że serwer niczego nie zrobił. Mówi tylko, że klient nie dostał odpowiedzi na czas. Jeśli automatycznie powtórzysz utworzenie zamówienia, wysłanie wiadomości albo zapis wpisu, możesz wykonać tę samą operację drugi raz.
Bezpieczne retry w automatyzacji wymaga dwóch decyzji: kiedy ponowić żądanie i jak rozpoznać, że ten sam zamiar został już zrealizowany. Pokażę oba mechanizmy oraz mały przykład z SQLite, który można sprawdzić bez korzystania z płatnego API.
Najtrudniejszy błąd: zapis się udał, odpowiedź zginęła
Wyobraź sobie taki przebieg:
- Klient prosi o utworzenie raportu.
- Serwer zapisuje zadanie w bazie i zatwierdza transakcję.
- Połączenie urywa się przed dostarczeniem odpowiedzi.
- Klient widzi timeout i nie zna identyfikatora raportu.
Drugi request może stworzyć drugi raport, choć użytkownik zamawiał tylko jeden. Sam dłuższy timeout zmniejsza częstotliwość problemu, ale nie usuwa tej klasy awarii.
Dlatego przy operacjach zapisu trzeba rozróżnić wynik „na pewno odrzucone” od „nie wiadomo, czy wykonane”. Wprowadzenie do metod i odpowiedzi REST API pomaga ustalić podstawy, jednak o konkretnych gwarancjach rozstrzyga kontrakt endpointu.
Które błędy nadają się do ponowienia
Nie buduj pętli obejmującej każdy wyjątek. Błąd danych wejściowych nie zniknie po pięciu sekundach, a ponawianie bez uprawnień nie naprawi tokena.
| Sytuacja | Typowa decyzja | Co sprawdzić |
|---|---|---|
| 400 lub 422 | Popraw dane, nie ponawiaj identycznego żądania w ciemno | Format i reguły walidacji |
| 401 lub 403 | Zatrzymaj i ustal przyczynę | Token, uprawnienia, ewentualny limit opisany przez API |
| 429 | Odczekaj według polityki usługi | Retry-After i dostępny budżet |
| 502, 503, 504 | Rozważ ograniczone retry | Czy operacja mogła już wywołać skutek |
| Timeout po wysłaniu danych | Traktuj wynik jako niepewny | Idempotencja lub możliwość sprawdzenia stanu |
Tabela jest punktem wyjścia, nie zamiennikiem dokumentacji. Niektóre systemy używają 409 dla trwającego żądania o tym samym kluczu, inne dla trwałego konfliktu danych. Ponowienie ma sens tylko po rozpoznaniu tego znaczenia.
Obsługę nagłówków i ograniczania tempa opisuje osobno poradnik o rate limit API. Tutaj skupiamy się na skutku biznesowym operacji, a nie tylko na statusie HTTP.
Klucz idempotencji oznacza jeden zamiar
Klient tworzy trwały identyfikator operacji przed pierwszym wysłaniem. Każda próba realizacji tego samego zamiaru używa tego samego klucza i tej samej treści. Nowa świadomie zlecona operacja dostaje nowy identyfikator.
Przykładowo zapis „utwórz raport dla zamówienia 123” może mieć klucz powiązany z identyfikatorem tego zadania. Nie generuj nowego UUID wewnątrz pętli retry. Wtedy każda próba wyglądałaby dla serwera jak nowe zlecenie.
Po stronie odbiorcy potrzebny jest trwały rejestr: klucz, zakres użytkownika lub klienta, porównywana treść oraz wynik. Gdy klucz wraca z innymi danymi, serwer powinien zgłosić konflikt zamiast cicho zwrócić rezultat niepasującej operacji.
Nazwa nagłówka, czas przechowywania klucza i zachowanie przy błędach zależą od usługi. Stripe dokumentuje własny mechanizm kluczy idempotencji, ale samo dodanie podobnego nagłówka do dowolnego API niczego nie gwarantuje. Serwer musi go rzeczywiście obsługiwać.
Przykład: jeden zapis w SQLite mimo ponowienia
Poniższy kod tworzy zadanie oraz zapisuje jego klucz w jednej bazie i jednej transakcji. To demonstracja dla jednego lokalnego systemu, bez uwierzytelniania i bez zewnętrznych efektów, takich jak płatność czy wysłanie e-maila.
Zapisz go jako idempotency.py:
import json
import sqlite3
from contextlib import closing


def initialize(path):
    with closing(sqlite3.connect(path)) as db, db:
        db.executescript('''
        CREATE TABLE IF NOT EXISTS jobs (
          id INTEGER PRIMARY KEY, payload TEXT NOT NULL);
        CREATE TABLE IF NOT EXISTS requests (
          key TEXT PRIMARY KEY, payload TEXT NOT NULL,
          job_id INTEGER NOT NULL REFERENCES jobs(id));
        ''')


def create_job(path, key, payload):
    # One local database is the complete side effect in this example.
    encoded = json.dumps(payload, sort_keys=True, separators=(',', ':'))
    with closing(sqlite3.connect(path, timeout=5)) as db:
        db.execute('PRAGMA foreign_keys = ON')
        try:
            db.execute('BEGIN IMMEDIATE')
            previous = db.execute(
                'SELECT payload, job_id FROM requests WHERE key = ?',
                (key,)).fetchone()
            if previous:
                if previous[0] != encoded:
                    raise ValueError('Same key with a different payload')
                job_id = previous[1]
            else:
                cursor = db.execute(
                    'INSERT INTO jobs(payload) VALUES (?)', (encoded,))
                job_id = cursor.lastrowid
                db.execute('INSERT INTO requests VALUES (?, ?, ?)',
                           (key, encoded, job_id))
            db.commit()
            return {'job_id': job_id}
        except Exception:
            db.rollback()
            raise
BEGIN IMMEDIATE rozpoczyna transakcję zapisu przed sprawdzeniem klucza. SQLite dopuszcza jednego zapisującego naraz, dlatego równoległe próby nie przechodzą niezależnie przez ścieżkę „jeszcze nie istnieje”. Ograniczenie PRIMARY KEY dodatkowo wymusza unikalność klucza.
Cały efekt przykładu mieści się w tej transakcji. Zapis rekordu w jobs i rejestru w requests zatwierdzamy razem. Zamknięcie połączenia jest jawne, ponieważ kontekst transakcji sqlite3 nie jest tym samym co zamknięcie połączenia.
W osobnym pliku testowym uruchom:
from idempotency import initialize, create_job

initialize("demo.db")
first = create_job("demo.db", "report-123", {"period": "weekly"})
# Wyobraz sobie, ze odpowiedz first nie dotarla do klienta.
second = create_job("demo.db", "report-123", {"period": "weekly"})
assert first == second
print(second)
Obie próby zwracają identyfikator tego samego zadania. Ponowne użycie klucza z innym period zakończy się błędem. Kod używa parametrów zapytania, a nie sklejania treści użytkownika z SQL. Podstawy transakcji przypomina ściąga SQL, choć składnia i blokady różnią się między bazami.
W lokalnym teście sprawdzono też dwanaście równoległych wywołań z drugim wspólnym kluczem. Powstał jeden dodatkowy rekord. To test tego przykładu SQLite, nie deklaracja gwarancji dla dowolnego systemu rozproszonego.
Gdzie kończy się ochrona transakcji
Wyobraź sobie, że między zapisem do jobs a commit wywołujesz zewnętrzny serwer pocztowy. Baza może wycofać transakcję, lecz wysłanej wiadomości nie cofnie. Lokalny rejestr nie daje wtedy automatycznie gwarancji jednego dostarczenia.
Jednym z rozwiązań jest zapis zadania do wysłania razem z danymi biznesowymi, a następnie osobny proces dostarczający. Nadal trzeba obsłużyć powtórne dostarczenie do odbiorcy. Pomaga jego klucz idempotencji, unikalny identyfikator zdarzenia lub możliwość uzgodnienia stanu po awarii.
Nie obiecuj więc „exactly once” tylko dlatego, że dodałeś tabelę z kluczem. Określ granicę gwarancji: jedna transakcja bazy, przyjęcie przez API czy końcowy efekt u zewnętrznego odbiorcy. Każda granica wymaga osobnego rozumowania.
W systemie wieloużytkownikowym klucz powinien być powiązany z zaufanym identyfikatorem klienta. Publiczny endpoint nie może zwracać czyjegoś wyniku tylko dlatego, że inny użytkownik podał ten sam tekst klucza.
Backoff i jitter: kiedy wykonać kolejną próbę
Nawet bezpieczny zapis nie powinien być ponawiany bez przerwy. Zastosuj limit liczby prób i czasu całego zadania. Opóźnienie może rosnąć, na przykład według schematu 1, 2, 4 i 8 sekund, z maksymalnym pułapem. Są to parametry przykładu, nie zalecenie dla każdego dostawcy.
Jitter dodaje losowość, aby wiele procesów nie wracało jednocześnie po awarii. Jeśli serwer przekazał poprawny Retry-After, nie losuj czasu krótszego niż wymagana pauza. Gdy oczekiwanie nie mieści się w budżecie, odłóż zadanie zamiast utrzymywać nieskończoną pętlę.
Sprawdź też, czy biblioteka HTTP lub SDK nie ponawia już żądań. Trzy próby na poziomie klienta i trzy na poziomie całego workflow mogą dać dziewięć wywołań jednego kroku. Potrzebujesz jednego spójnego budżetu, nawet jeśli implementacja ma kilka warstw.
Retry pojedynczego kroku a restart całego workflow
Przepływ może kolejno utworzyć rekord, wygenerować plik i wysłać powiadomienie. Jeśli zawiedzie ostatni krok, ponowienie wszystkiego od początku wymaga ochrony każdego wcześniejszego efektu. Często lepiej zapisywać stan etapów i wznawiać od miejsca awarii.
W workflow n8n odróżnij obsługę błędu węzła od ręcznego ponowienia całego wykonania. Historia przebiegu ułatwia diagnozę, ale nie zastępuje trwałego klucza operacji po stronie systemu zapisującego dane.
Podobnie odbiornik webhooków powinien liczyć się z ponownym dostarczeniem zdarzenia. Identyfikator eventu od dostawcy jest przydatny do deduplikacji, jeśli jego zakres i stabilność są udokumentowane. Sam czas odebrania wiadomości nie identyfikuje zdarzenia.
Zadania uruchamiane przez cron nie powinny nakładać się bez kontroli. Blokada wykonania i idempotencja rozwiązują różne problemy: pierwsza ogranicza współbieżność, druga chroni przed wielokrotnym skutkiem tego samego zamiaru.
Co zapisać w logach i jak sprawdzić rozwiązanie
Loguj identyfikator operacji, numer próby, status, powód ponowienia i następny termin. Nie zapisuj tokena ani całego poufnego body. Przy wyczerpaniu prób skieruj zadanie do ręcznego sprawdzenia i wyślij pojedynczy alert administracyjny.
Przed wdrożeniem sprawdź co najmniej: utraconą odpowiedź po zatwierdzeniu zapisu, jednoczesne żądania z tym samym kluczem, zmianę danych przy zachowanym kluczu i restart procesu. Osobno ustal okres przechowywania rejestru. Usunięcie klucza zbyt wcześnie może zamienić stare ponowienie w nową operację.
Najczęstsze pytania
Czy każdy POST jest niebezpieczny do ponawiania?
Nie każdy, ale nie można zakładać jego idempotencji na podstawie samej metody. Sprawdź kontrakt endpointu. API może udostępniać bezpieczne ponowienia przez klucz operacji albo inną udokumentowaną regułę.
Gdzie generować klucz idempotencji?
Przed pierwszą próbą, przy tworzeniu trwałego zadania. Zapisz go razem z danymi operacji, aby przetrwał restart procesu. Nie generuj nowego klucza przy każdym wyjątku sieciowym.
Czy wystarczy sprawdzić, czy rekord istnieje?
Nie, jeśli pomiędzy sprawdzeniem a zapisem inny proces może zrobić to samo. Potrzebna jest ochrona na poziomie bazy: odpowiednia transakcja, unikalność i obsługa konfliktu.
Ile razy ponawiać zadanie?
Ustal limit prób oraz łączny budżet czasu według znaczenia operacji i polityki API. Po ich wyczerpaniu zachowaj stan do wyjaśnienia. Nieskończone retry ukrywa awarię i może zwiększać obciążenie.
Czy przykład SQLite zapewnia pojedyncze wysłanie e-maila?
Nie. Chroni tylko zapis zadania i rejestru w tej samej bazie. Zewnętrzna wysyłka wymaga odrębnej strategii dostarczenia i obsługi niepewnego wyniku.
Źródła
- IETF: RFC 9110, metody idempotentne i ponawianie HTTP.
- Stripe: kontrakt żądań idempotentnych.
- AWS: budżety ponowień, backoff i jitter.
- SQLite: transakcje i BEGIN IMMEDIATE.
- Python: sqlite3, parametry zapytań i połączenia.
- PostgreSQL: ograniczenia unikalności i klucze.
- n8n: obsługa błędów workflow.
Data publikacji: 26.10.2026.
Dyskusja