
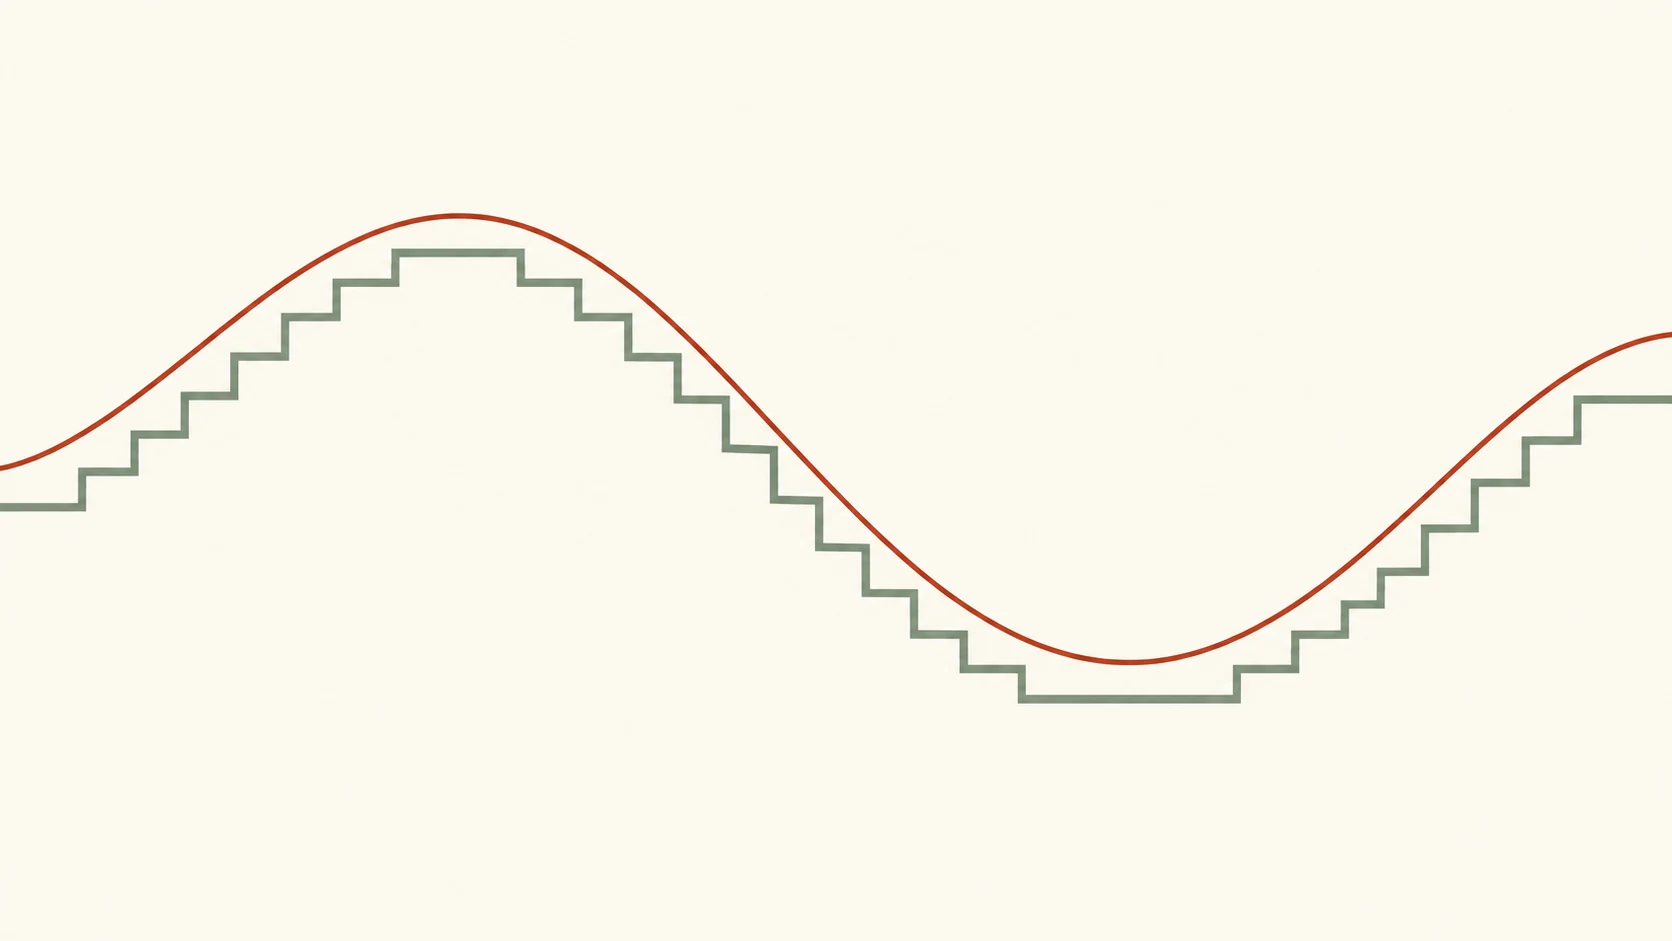
Plik modelu mieści się na dysku, ale po uruchomieniu kończy się pamięć GPU. Pobierasz mniejszy wariant Q4 i model zaczyna działać, lecz niektóre odpowiedzi się pogarszają. Kwantyzacja modeli AI jest kompromisem między sposobem zapisu wag, wymaganiami pamięciowymi i zachowaniem modelu. Sama etykieta Q4 lub Q8 nie mówi jeszcze, który plik będzie najlepszy na Twoim komputerze.
Wyjaśnię znaczenie Q4, Q5, Q8 i FP16, policzę przybliżony koszt przechowywania wag oraz pokażę, jak porównywać warianty bez mylenia rozmiaru pliku z całym zużyciem VRAM. To poradnik doboru i interpretacji, nie benchmark konkretnych kart graficznych.
Co właściwie podlega kwantyzacji
Model językowy korzysta z dużych zbiorów liczb opisujących jego parametry. Im mniej bitów przeznaczasz na zapis wartości, tym mniej różnych wartości można bezpośrednio zakodować. Kwantyzacja mapuje liczby na bardziej ograniczoną reprezentację, zwykle z dodatkowymi informacjami potrzebnymi do ich odtworzenia podczas obliczeń.
Przydatna analogia to zaokrąglenie kwoty do pełnych złotych. Zapis jest prostszy, ale znika informacja o groszach. W modelach stosuje się bardziej złożone metody niż zwykłe zaokrąglanie każdej liczby tak samo. Ważne są między innymi grupy wag, skale i dobór precyzji dla różnych części sieci.
Kwantyzacja nie jest tym samym co usuwanie parametrów ani trenowanie mniejszego modelu. Wariant 7B Q4 nadal może reprezentować tę samą architekturę i liczbę parametrów co wariant 7B FP16. Zmienia się sposób przechowywania i używania liczb.
Nie należy też zakładać, że wszystkie obliczenia odbywają się w precyzji podanej w nazwie pliku. Format wag i precyzja obliczeń to powiązane, lecz odrębne elementy implementacji.
Q4, Q5, Q8 i FP16 w praktyce
| Oznaczenie | Co sugeruje | Czego nie gwarantuje |
|---|---|---|
| Q4 | Rodzina wariantów z wagami zapisywanymi głównie w okolicach 4 bitów | Dokładnie 4 bitów na każdy parametr całego pliku |
| Q5 | Rodzina wariantów około 5-bitowych | Jednego uniwersalnego algorytmu i jakości |
| Q8 | Rodzina wariantów około 8-bitowych | Identycznej reprezentacji jak FP16 |
| FP16 / F16 | 16-bitowy format zmiennoprzecinkowy | Całkowitego zużycia pamięci równego rozmiarowi wag |
FP16 jest innym formatem niż BF16, mimo że oba używają 16 bitów. Różnią się podziałem bitów i właściwościami numerycznymi. Nie traktuj nazw jako zamiennych, jeśli narzędzie wymaga konkretnego formatu wejściowego.
Przy porównaniu Q4 i Q8 zacznij od wariantów tego samego modelu. Zestawienie dwóch różnych rodzin lub rozmiarów miesza wpływ kwantyzacji z wpływem architektury i treningu. Większy model w niższej precyzji może w danym zadaniu wygrać z mniejszym w wyższej, ale nie wynika z tego uniwersalna reguła.
Co znaczą końcówki Q4_K_M i Q5_K_S
W ekosystemie llama.cpp i plików GGUF spotkasz pełniejsze nazwy, na przykład Q4_K_M. Końcówka jest ważna: wskazuje wariant sposobu kwantyzacji, a nie ozdobny opis rozmiaru.
Warianty K korzystają z kwantyzacji blokowej. Oznaczenia S i M rozróżniają warianty konfiguracji, w tym dobór precyzji dla części tensorów. Nie należy czytać Q4_K_M jako obietnicy, że każda liczba w pliku zajmuje dokładnie cztery bity.
Samo K nie oznacza długości kontekstu. Podobnie Q8 nie znaczy „model z kontekstem 8000 tokenów”. Długość kontekstu jest osobnym parametrem modelu i uruchomienia, opisanym w artykule o oknie kontekstowym.
Nie wszystkie narzędzia używają identycznej nomenklatury. Przy plikach z różnych ekosystemów sprawdzaj obsługiwany format, a nie tylko cyfrę przy literze Q.
Ile pamięci zajmują same wagi
Na początek można policzyć prosty model kosztu:
liczba parametrów × liczba bitów / 8 = liczba bajtów
Dla hipotetycznego modelu z dokładnie siedmioma miliardami parametrów otrzymasz:
| Nominalny zapis | Same liczby, GB dziesiętne | Przybliżenie w GiB |
|---|---|---|
| 4 bity | 3,50 GB | 3,26 GiB |
| 5 bitów | 4,375 GB | 4,07 GiB |
| 8 bitów | 7,00 GB | 6,52 GiB |
| 16 bitów | 14,00 GB | 13,04 GiB |
To rachunek teoretyczny bez narzutu, a nie tabela rzeczywistych wymagań modeli. GB oznacza tutaj miliard bajtów, natomiast GiB to 2 do potęgi 30 bajtów. Plik może zawierać skale, metadane i elementy zapisane w wyższej precyzji. Marketingowa nazwa „7B” również nie zawsze oznacza dokładnie 7 000 000 000 parametrów.
Możesz powtórzyć obliczenie w Pythonie:
parameters = 7_000_000_000
for bits in (4, 5, 8, 16):
    size = parameters * bits / 8
    print(bits, f"{size / 1e9:.3f} GB", f"{size / 2**30:.2f} GiB")
Przy modelach MoE zwracaj uwagę na rozróżnienie parametrów wszystkich ekspertów i parametrów aktywnych dla tokenu. Mała liczba aktywnych parametrów nie oznacza automatycznie, że wystarczy przechować tylko taki fragment całego modelu.
Dlaczego plik 5 GB może nie zmieścić się w 8 GB VRAM
Poza wagami potrzebna jest pamięć na stan przetwarzania, bufory i kontekst rozmowy. Znaczenie mają też liczba równoległych żądań, implementacja silnika oraz inne programy używające GPU.
Częścią tego kosztu jest KV cache, czyli pamięć związana z wcześniejszymi tokenami przetwarzanej sekwencji. Jej wymagania zależą od architektury i ustawień. Większy kontekst może istotnie zwiększyć zużycie pamięci bez zmiany pliku z wagami.
Dlatego test „model się załadował” jest za krótki. Sprawdź również dłuższe wejście, generowanie odpowiedzi i liczbę rozmów potrzebną w praktyce. Zostaw zapas na pozostałe procesy zamiast planować zajęcie całej pamięci co do megabajta.
Ollama może umieścić model częściowo na CPU. To może pozwolić go uruchomić, ale nie jest równoznaczne z wydajnością pełnego wykonania na GPU. Zwiększanie swapu na VPS-ie nie zastępuje VRAM-u i może prowadzić do bardzo wolnej pracy.
Jak sprawdzić wariant używany przez Ollamę
Najpierw odczytaj nazwy pobranych modeli:
ollama list
Dla istniejącego modelu, na przykład qwen3:0.6b, sprawdź szczegóły:
ollama show qwen3:0.6b
Nazwę zastąp modelem z własnej listy. Tag nie musi sam zawierać pełnego oznaczenia kwantyzacji, dlatego sprawdź rzeczywiste dane modelu. Możesz też odczytać je przez API:
curl --silent --show-error --fail-with-body \
  http://127.0.0.1:11434/api/show \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3:0.6b"}'
W odpowiedzi szukaj informacji o formacie i quantization_level w szczegółach modelu. Z kolei podczas aktywnej pracy polecenie ollama ps pokazuje miejsce załadowania modelu oraz kontekst. Nie utożsamiaj wyniku ollama list opisującego pliki z użyciem pamięci procesu w trakcie generowania.
Instalację i pierwsze uruchomienie opisuje poradnik Ollamy. Jeśli wolisz czat w przeglądarce, skorzystaj z konfiguracji Open WebUI i Ollamy.
Jak porównać jakość bez zgadywania
Przygotuj niewielki zestaw własnych zadań i oczekiwanych rezultatów. Dla asystenta programisty mogą to być poprawienie konkretnej funkcji, wskazanie przyczyny błędu oraz wygenerowanie JSON-a o zadanym schemacie. Dla wyszukiwarki dokumentów potrzebujesz pytań z odpowiedziami wynikającymi ze źródeł.
Porównuj te same wersje modelu, prompt, kontekst i ustawienia generowania. Zapisz pełną nazwę pliku lub identyfikator, wersję silnika i sprzęt. Bez tego później trudno ustalić, czy zmieniła się kwantyzacja, model czy konfiguracja.
Oceniaj oddzielnie:
- poprawność odpowiedzi i zgodność z instrukcją,
- czas do pierwszego tokenu,
- szybkość dalszego generowania,
- szczytowe zużycie pamięci,
- stabilność przy dłuższym kontekście.
Oddziel również zimny start, obejmujący ładowanie modelu, od kolejnego żądania do już załadowanych wag. Jedna krótka rozmowa nie daje podstaw do ogłoszenia, że „Q4 jest zawsze równie dobre”. Nie ma też uczciwej stałej procentowej utraty jakości wspólnej dla wszystkich modeli i zadań.
Jeśli wynik ma być JSON-em, sprawdzaj strukturę parserem i walidatorem, nie tylko wygląd odpowiedzi. Formatter JSON pomaga w ręcznym przeglądzie, ale sam nie potwierdza spełnienia całego schematu aplikacji.
GGUF i ponowna kwantyzacja
GGUF jest formatem pliku przechowującym tensory oraz metadane. Nie jest pojedynczym poziomem jakości. Dwa pliki GGUF mogą mieć zupełnie inne typy tensorów i wymagania sprzętowe.
Jeżeli dopiero zaczynasz, łatwiej wybrać gotowy, udokumentowany wariant z zaufanego źródła niż samodzielnie konwertować model. Sprawdź pochodzenie wag, obsługę architektury w używanym silniku oraz licencję modelu.
Przy samodzielnym przygotowaniu kwantyzacji zacznij od dostępnych wag o wysokiej precyzji. Przekonwertowanie Q4 na Q8 nie odzyska informacji utraconej wcześniej. Ponowna kwantyzacja już skwantyzowanych tensorów może dodatkowo pogorszyć wynik.
Nie myl też kwantyzacji modelu generującego tekst z doborem modelu embeddingowego. W wyszukiwaniu opartym na embeddings zmiana modelu lub reprezentacji wymaga osobnej oceny trafności i zgodności indeksu.
Najczęstsze pytania
Czy Q8 zawsze odpowiada lepiej niż Q4?
Wyższa precyzja może lepiej zachować zachowanie modelu bazowego, ale nie daje gwarancji lepszej odpowiedzi na każde pytanie. Wynik oceń na własnym zestawie zadań i porównywalnych ustawieniach.
Czy Q4 oznacza cztery miliardy parametrów?
Nie. Q4 dotyczy sposobu zapisu liczb. Liczbę parametrów opisują inne elementy nazwy, na przykład 7B lub 14B.
Czy kwantyzacja zawsze przyspiesza model?
Nie. Mniejsze wagi mogą zmniejszyć ruch pamięci i ułatwić zmieszczenie modelu na GPU, lecz szybkość zależy od sprzętu oraz obsługi danego formatu przez silnik.
Dlaczego po zwiększeniu kontekstu zabrakło pamięci?
Zmienił się koszt stanu przetwarzania, mimo że plik modelu jest ten sam. Zmniejsz kontekst lub liczbę równoległych żądań i zmierz ponownie rzeczywiste zużycie.
Który wariant wybrać na początek?
Porównaj udokumentowany wariant około 4- lub 5-bitowy z wyższą precyzją, jeśli sprzęt na to pozwala. Wybierz mniejszy tylko wtedy, gdy mieści się z zapasem i spełnia wymagania jakościowe Twojego zadania. Nie istnieje jeden wariant najlepszy dla wszystkich.
Źródła
- Hugging Face: przegląd kwantyzacji.
- Hugging Face: pojęcia i mechanizmy kwantyzacji.
- Hugging Face: GGUF i typy kwantyzacji.
- Projekt llama.cpp: narzędzie llama-quantize i ponowna kwantyzacja.
- Projekt llama.cpp: obsługiwane warianty kwantyzacji.
- Ollama: odczyt szczegółów modelu przez API.
- Ollama: kontekst i zużycie pamięci.
- Ollama: sprawdzanie użycia CPU i GPU.
Data publikacji: 23.10.2026.
Dyskusja