
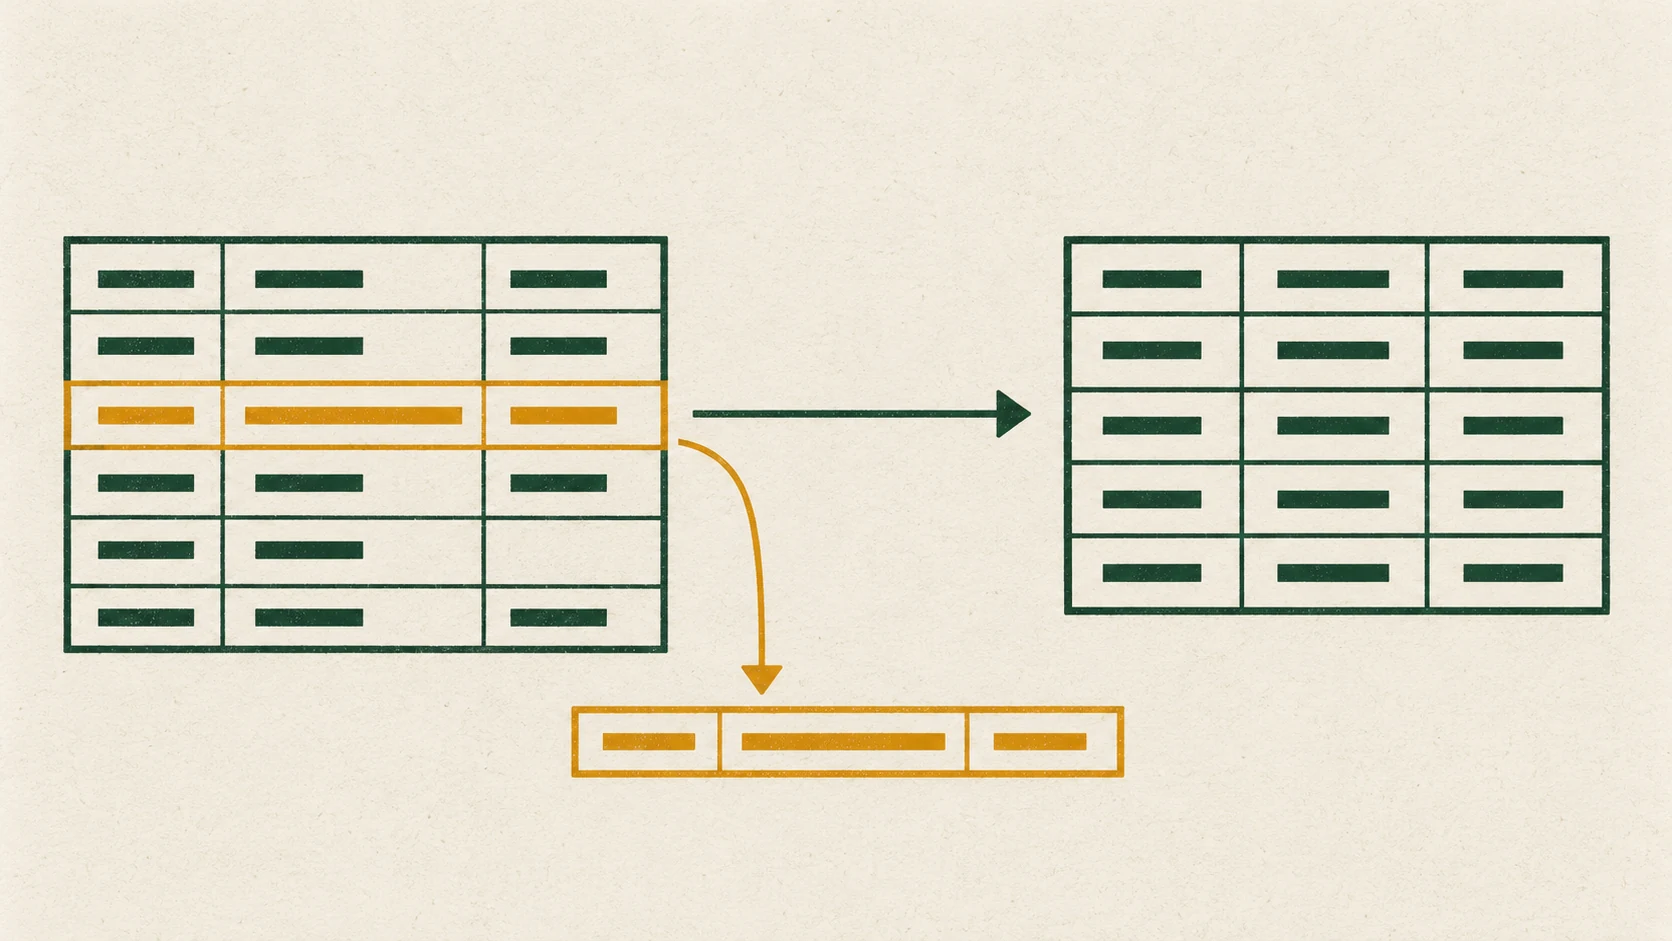
Skrypt może poprawnie otworzyć plik CSV i jednocześnie zepsuć jego znaczenie: obciąć zero z identyfikatora, źle odczytać kwotę albo nadpisać dobry wynik niepełnymi danymi. Automatyczne przetwarzanie CSV wymaga więc ustalenia formatu wejścia oraz zasad odrzucania błędów, zanim uruchomisz harmonogram.
Przygotujemy niewielki proces: folder wejściowy, walidację i wynik zapisywany dopiero po sprawdzeniu całej partii. Przykład korzysta wyłącznie z biblioteki standardowej Pythona. Zachowuje pliki źródłowe i nie wymaga arkusza kalkulacyjnego.
Ustal kontrakt pliku, nie tylko rozszerzenie
Nazwa .csv nie rozstrzyga, jaki separator, kodowanie i format liczb znajdziesz w środku. Eksport z polskiego systemu może używać średnika, przecinka dziesiętnego i znacznika BOM. Inny plik może rozdzielać pola przecinkiem oraz obejmować tekst cudzysłowami.
Przed napisaniem automatyzacji zapisz cztery rzeczy: nazwy i kolejność kolumn, kodowanie, separator oraz typ każdej wartości. Ustal też znaczenie pustego pola. Pusta kwota, zero i brak kolumny to trzy różne sytuacje.
W naszym przykładzie obowiązuje następujący format:
id;kwota
001;12,50
002;0,1
id to tekst zawierający od jednej do dwudziestu cyfr ASCII. Zachowujemy początkowe zera. kwota to nieujemna liczba z maksymalnie dwoma miejscami po przecinku, bez separatora tysięcy. Plik używa UTF-8, z opcjonalnym BOM. Nagłówek ma dokładnie dwie kolumny: id;kwota.
To celowo wąski kontrakt. Jeśli źródło dopuszcza zwroty z kwotą ujemną albo inne kolumny, zmień reguły świadomie i dodaj próbki do testu. Nie rozszerzaj parsera tak, żeby zgadywał wszystko i po cichu poprawiał niejednoznaczne dane.
Dlaczego split po przecinku nie wystarczy
Pole CSV może zawierać separator wewnątrz cudzysłowów, a nawet znak końca linii. Zwykłe line.split(',') nie rozumie tych reguł. Biblioteka csv obsługuje cytowanie pól i ustalony dialekt formatu.
Plik otwieramy z newline='', aby parser sam obsługiwał znaki końca linii. Kodowanie utf-8-sig pozwala odczytać UTF-8 z BOM oraz bez niego. Nie naprawia pliku w Windows-1250 ani innego niezgodnego eksportu. Błędne kodowanie powinno przerwać zadanie i dać czytelny powód.
Nie polegaj bezwarunkowo na automatycznym wykrywaniu separatora. Krótki lub nietypowy fragment danych może prowadzić do błędnej decyzji. Jeżeli obsługujesz jednego stałego nadawcę, jawny separator jest prostszy do utrzymania. Kilku nadawców może wymagać osobnych profili importu.
Automatyczne przetwarzanie CSV w Pythonie
Utwórz katalog roboczy z podkatalogami inbox i out. Plik wejściowy zapisz jako inbox/dane.csv, a poniższy kod jako convert.py. Wynik musi znajdować się poza folderem wejściowym, żeby nie został potraktowany jako kolejny plik źródłowy.
import csv
import os
import re
import sys
import tempfile
from decimal import Decimal
from pathlib import Path

def convert(inbox, output):
    files = sorted(Path(inbox).glob('*.csv'))
    if not files:
        raise ValueError('No input files')
    records = {}
    for path in files:
        with path.open(encoding='utf-8-sig', newline='') as stream:
            reader = csv.DictReader(stream, delimiter=';', strict=True)
            if reader.fieldnames != ['id', 'kwota']:
                raise ValueError(f'{path.name}: expected id;kwota')
            for row in reader:
                key, amount = row.get('id'), row.get('kwota')
                if None in row or not isinstance(key, str) or not re.fullmatch(r'[0-9]{1,20}', key):
                    raise ValueError(f'{path.name}: invalid ID or column count')
                if not isinstance(amount, str) or not re.fullmatch(r'[0-9]{1,12}(,[0-9]{1,2})?', amount):
                    raise ValueError(f'{path.name}: invalid amount')
                if key in records:
                    raise ValueError(f'{path.name}: duplicate ID {key}')
                records[key] = Decimal(amount.replace(',', '.'))
    output = Path(output)
    output.parent.mkdir(parents=True, exist_ok=True)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(mode='w', encoding='utf-8', newline='',
                                         dir=output.parent, delete=False) as stream:
            temporary = Path(stream.name)
            writer = csv.writer(stream)
            writer.writerow(['id', 'amount'])
            for key in sorted(records):
                writer.writerow([key, format(records[key], '.2f')])
        os.replace(temporary, output)
    finally:
        if temporary is not None:
            temporary.unlink(missing_ok=True)
    return len(records)

if __name__ == '__main__':
    print(convert(sys.argv[1], sys.argv[2]))
Uruchomienie z katalogu projektu:
python convert.py inbox out/result.csv
Na systemie, w którym interpreter nazywa się python3, użyj tej nazwy. Skrypt wypisze liczbę zapisanych rekordów. Dla danych z początku poradnika wynik będzie następujący:
id,amount
001,12.50
002,0.10
Wynik używa przecinka jako separatora pól oraz kropki dziesiętnej. To nowy, jawnie zdefiniowany format, a nie zachowanie całego oryginalnego pliku. Jeśli dalszy system oczekuje średnika, dostosuj csv.writer i test końcowy razem.
Co jest sprawdzane przed zapisem
Nagłówek musi pasować dokładnie. Literówka w kwota nie zamieni całej kolumny w puste wartości. Zbyt duża liczba pól zostanie odrzucona, podobnie jak brak wymaganej wartości. Powtarzający się identyfikator zatrzymuje partię, również gdy duplikat występuje w innym pliku.
Kwoty powstają z tekstu przez Decimal, bez pośredniego float. Najpierw sprawdzamy składnię i maksymalną liczbę cyfr. Dzięki temu NaN, zapis wykładniczy i nadmiar miejsc dziesiętnych nie przechodzą przypadkiem jako poprawne kwoty. W tym kontrakcie nadmiaru precyzji nie zaokrąglamy automatycznie.
Wynik jest sortowany według tekstowego ID. To porządek deterministyczny, nie sortowanie liczbowe. Jeżeli identyfikatory mają różne długości, 10 może pojawić się przed 2. Zera pozostają częścią identyfikatora, więc 001 oraz 1 są różnymi kluczami.
Taki zestaw zasad jest odpowiedni dla małej, kontrolowanej partii. Skrypt przechowuje wszystkie rekordy w pamięci. Przy wielkich eksportach użyj przetwarzania partiami i bazy pośredniej z ograniczeniami unikalności. Podstawy zapytań przyda się mieć pod ręką w ściądze SQL.
Zły plik nie powinien niszczyć dobrego wyniku
Program najpierw sprawdza całą partię. Dopiero potem tworzy plik tymczasowy w tym samym katalogu co wynik i zastępuje result.csv przez os.replace. Jeśli walidacja zatrzyma się wcześniej, dotychczasowy wynik pozostaje nietknięty.
W lokalnych testach potwierdzono odczyt BOM, przecinek dziesiętny, zachowanie początkowego zera, powtarzalny wynik oraz pomijanie pliku .part. Niepoprawny nagłówek, duplikat, NaN, nadmiar precyzji, identyfikator przypominający formułę i dodatkowa kolumna zostały odrzucone. Po błędnych partiach poprzedni plik wynikowy nadal miał tę samą zawartość.
Podmiana pliku nie jest jednak pełnym systemem transakcyjnym. Atomowość operacji nie daje automatycznie odporności na utratę zasilania, archiwizacji ani koordynacji kilku procesów. Dwa równoległe uruchomienia mogą przygotować różne wyniki i kolejno zastąpić ten sam plik.
Na tym etapie przyjmujemy jednego wykonawcę. W zadaniu cyklicznym zastosuj blokadę, np. flock w Linuxie. Wzorzec blokowania i ustawienia środowiska znajdziesz w poradniku o cronie.
Nie czytaj pliku, który właśnie się kopiuje
Skanowanie folderu co minutę nie oznacza, że każdy znaleziony plik jest kompletny. Duży eksport może nadal być przesyłany. Ustal z nadawcą prosty protokół: zapis do nazwy tymczasowej, zamknięcie pliku, a następnie zmiana nazwy na docelowe .csv w tym samym systemie plików.
Przykład przetwarza tylko *.csv, dlatego raport.part nie trafia do wejścia. Nie sprawdza samodzielnie, czy nadawca dotrzymał umowy. Czekanie, aż rozmiar przez chwilę się nie zmienia, jest heurystyką, a nie pewnym sygnałem zakończenia transferu.
Kod pobiera listę nazw raz na początku uruchomienia. Nowy plik dodany później trafi do kolejnej partii. Nadawca nie powinien modyfikować już udostępnionych plików w trakcie odczytu. Przy wymaganej spójności użyj osobnego katalogu gotowej partii lub manifestu określającego jej zawartość.
Oryginały zostają na miejscu. To oznacza, że kolejne uruchomienie przeliczy cały folder, zamiast dopisywać wyłącznie nowe wiersze. Dla małego zbioru jest to czytelne i powtarzalne. Przy rosnącym archiwum potrzebujesz rejestru przetworzonych partii i reguł ponowienia. Omawia je poradnik o idempotencji i retry.
Kwarantanna, logi i alarmy
W tym wariancie jeden błędny plik zatrzymuje cały wynik. Dzięki temu odbiorca nie dostaje po cichu niepełnej partii. Alternatywa, czyli eksport poprawnych rekordów z osobną listą odrzuceń, też może być rozsądna, lecz wymaga uzgodnienia z odbiorcą danych.
Nie przenoś automatycznie wszystkich plików do archiwum po samej próbie uruchomienia. Najpierw potwierdź zapis wyniku i jego przyjęcie przez kolejny etap, jeśli jest wymagane. Kwarantanna powinna zawierać oryginał oraz powód odrzucenia, bez przepisywania danych tak, by błąd zniknął z historii.
Loguj nazwę partii, czas, liczbę plików, liczbę rekordów i kod zakończenia. Nie zapisuj całych danych osobowych czy poufnych wartości tylko po to, żeby łatwiej debugować. Przy regularnym imporcie brak plików może być alarmem, a w innym procesie normalnym zdarzeniem. Przykład świadomie traktuje pusty folder jako błąd.
Powiadomienie powinno zawierać nazwę zadania i przyczynę, a nie kopię całego pliku. Sposób wysyłania kontrolowanych alarmów pokazuje poradnik o powiadomieniach z serwera.
CSV otwierany w arkuszu ma dodatkowe ryzyko
Poprawne cytowanie pól nie blokuje interpretacji formuł przez arkusz kalkulacyjny. Tekst zaczynający się od znaków specjalnych może zostać potraktowany inaczej niż zwykła etykieta. Dlatego ochrona przed CSV Injection jest osobnym problemem od poprawnego parsowania separatorów.
Nasz wynik zawiera wyłącznie identyfikator ograniczony do cyfr i sformatowaną nieujemną kwotę. Nie eksportuje dowolnych komentarzy użytkowników. Po dodaniu pól tekstowych trzeba na nowo ocenić sposób bezpiecznego otwierania danych w docelowym programie. Nie zakładaj, że samo otoczenie cudzysłowami załatwia sprawę.
Oddziel też konto wykonujące import od konta administracyjnego. Proces potrzebuje odczytu wejścia i zapisu do własnego katalogu wynikowego. Nie potrzebuje uprawnień do całego serwera. Komendy pracy z katalogami i uprawnieniami zbiera ściąga Linuxa.
Najczęstsze pytania
Czy do automatycznego przetwarzania CSV potrzebuję pandas?
Nie przy tak wąskim formacie. Biblioteka standardowa wystarcza do odczytu, walidacji i zapisu. Dodatkowe narzędzia dobieraj do operacji i rozmiaru danych, a nie do samego rozszerzenia pliku.
Dlaczego Excel usuwa zera z identyfikatora?
Arkusz może rozpoznać kolumnę jako liczbową. Skrypt zachowuje ID jako tekst, ale sposób importu do arkusza nadal musi uwzględniać tekstowy typ kolumny. Sam plik CSV nie przechowuje pełnego schematu typów arkusza.
Jak obsłużyć kwotę z przecinkiem?
Najpierw ustal separator pól i dozwoloną składnię liczby. W przykładzie pola rozdziela średnik, a przecinek dziesiętny zamieniamy na kropkę dopiero przed utworzeniem Decimal.
Co się stanie po błędzie w jednym pliku?
Cała partia zostanie odrzucona przed podmianą wyniku. Poprzedni result.csv pozostanie dostępny. Monitoring powinien odróżniać ten stary wynik od sukcesu nowego uruchomienia.
Czy mogę uruchamiać skrypt co minutę?
Tak, jeśli czas wykonania i sposób dostarczania plików na to pozwalają. Dodaj blokadę równoległych uruchomień, kontrolę kodu zakończenia i jasną regułę oznaczania gotowych plików.
Źródła
- Parser CSV, dialekty i newline, Python Documentation.
- Arytmetyka dziesiętna Decimal, Python Documentation.
- Podmiana pliku przez os.replace, Python Documentation.
- Pliki tymczasowe, Python Documentation.
- RFC 4180: wspólny format CSV, Y. Shafranovich, IETF.
- CSV Injection, OWASP.
Data publikacji: 31.10.2026.
Dyskusja